
Aller au contenu principal
Adaptation spatio-temporelle multi-cycles dans le travail en équipe humain-robot
RecherchearXiv cs.RO 

Adaptation spatio-temporelle multi-cycles dans le travail en équipe humain-robot
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Adaptation spatio-temporelle multi-cycles dans le travail en équipe humain-robot
▶ Voir sur YouTube

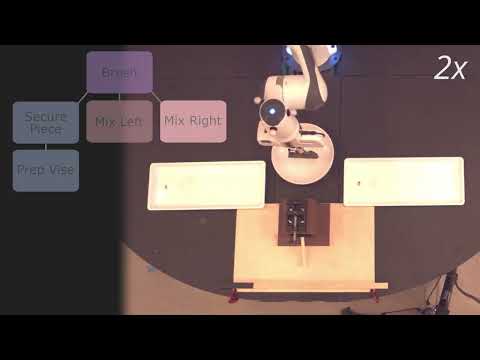
Une équipe de chercheurs a publié sur arXiv (ref. 2404.19670) un framework baptisé RAPIDDS, conçu pour améliorer la collaboration entre humains et robots dans des environnements industriels répétitifs, typiquement les lignes de fabrication. Le système opère sur plusieurs cycles de travail successifs : à chaque cycle, il apprend les comportements spatiaux (trajectoires réelles empruntées par l'opérateur) et temporels (temps effectifs de réalisation de chaque tâche) propres à l'individu face à lui. Ces modèles personnalisés alimentent ensuite deux mécanismes couplés : un planificateur de tâches qui réorganise allocations et séquençages, et un modèle de diffusion qui steer les trajectoires du robot en temps réel pour éviter les zones de proximité critique. Les expériences ont été conduites en simulation, puis sur un bras robotique à 7 degrés de liberté (7-DOF) dans un scénario physique, et validées par une étude utilisateur portant sur 32 participants (n=32). Les résultats montrent une amélioration significative sur des indicateurs objectifs (efficacité, distance de proximité) et subjectifs (fluidité perçue, préférence utilisateur) par rapport à un système non adaptatif.

L'apport central de RAPIDDS réside dans la jonction de deux niveaux d'adaptation longtemps traités séparément dans la littérature. Les méthodes de planification de tâches optimisaient l'allocation et le séquençage mais ignoraient les interférences spatiales en situation de proximité étroite ; les méthodes de niveau motion se concentraient sur l'évitement de collision sans tenir compte du contexte global de la tâche. Unifier les deux, en les calibrant sur un modèle individuel mis à jour cycle après cycle, représente un changement concret de posture pour les déploiements industriels : le robot ne s'adapte pas à un opérateur générique, mais à la personne précise qui travaille ce jour-là, avec ses rythmes et ses habitudes de déplacement.

Ce travail s'inscrit dans un courant plus large d'utilisation des modèles de diffusion pour la génération de trajectoires robotiques, un terrain que des acteurs comme Physical Intelligence (Pi-0) ou NVIDIA (GR00T N2) exploitent côté manipulation généraliste. RAPIDDS se distingue par sa focalisation sur la couche adaptation humain-robot plutôt que sur la polyvalence du modèle de motion. Le papier reste pour l'instant un preprint arXiv non encore soumis à peer-review, et aucun déploiement industriel ni partenariat avec un intégrateur n'est mentionné. La prochaine étape naturelle serait une validation sur des opérateurs en conditions réelles de production, avec une diversité de profils moteurs, pour tester la robustesse de la personnalisation au-delà d'un environnement contrôlé.

À lire aussi

Adaptation mutuelle dans le co-transport humain-robot avec incertitude sur les préférences humaines
1arXiv cs.RO 

Adaptation mutuelle dans le co-transport humain-robot avec incertitude sur les préférences humaines

Une équipe de chercheurs a publié en mars 2025 sur arXiv (référence 2503.08895) un cadre unifié de co-transport humain-robot fondé sur l'adaptation mutuelle, visant à résoudre un problème central de la robotique collaborative physique : comment un robot peut-il s'adapter en temps réel à un partenaire humain dont les préférences de trajectoire sont incertaines, et réciproquement ? L'article propose trois contributions distinctes. Plutôt que de fixer a priori les paramètres comportementaux du partenaire, les auteurs modélisent une distribution de probabilité sur l'ensemble des préférences possibles. Ils introduisent ensuite une mesure d'obstination (stubbornness) variant dans le temps, qui détermine dynamiquement si le robot doit mener la trajectoire ou céder la direction à l'humain lorsque celui-ci manifeste une préférence forte et persistante au-delà d'un seuil défini. Enfin, une stratégie d'optimisation de posture s'applique au niveau du contrôle bas-niveau pour compenser les comportements imprévisibles quand l'humain prend les commandes. Le cadre a été validé auprès de vingt participants, complété par des simulations comparatives. Ce travail adresse un verrou technique majeur pour les robots collaboratifs physiques en logistique, industrie et assistance à la personne : l'écart entre les modèles humains supposés et la variabilité réelle des opérateurs. En introduisant une modélisation probabiliste plutôt que déterministe des préférences, le framework évite le blocage classique des systèmes à paramètres fixes qui échouent dès que l'humain dévie du comportement anticipé. Pour un intégrateur ou un COO industriel, le signal concret est que des robots de co-manutention pourraient s'adapter à différents opérateurs sans reprogrammation, réduisant les coûts de déploiement multi-site. La bascule dynamique entre modes "robot meneur" et "humain meneur" offre par ailleurs une flexibilité opérationnelle utile dans des contextes où l'ergonomie ou la sécurité prime sur l'optimisation de trajectoire. Le co-transport physique humain-robot reste peu industrialisé comparé aux AMR ou aux cobots de type Universal Robots et FANUC CRX. Les approches antérieures à impédance variable ou fondées sur des modèles de jeu de Stackelberg avaient posé des bases théoriques, mais butaient sur la rigidité des hypothèses comportementales. Ce papier s'inscrit dans une tendance plus large à intégrer l'incertitude humaine dans la boucle de contrôle, direction explorée notamment par le MIT CSAIL et, en France, par l'INRIA au travers de travaux sur la planification collaborative. Les prochaines étapes probables incluent des validations en environnement industriel réel et l'extension à des tâches multi-étapes, où la gestion de l'obstination sur des horizons temporels plus longs constituera un défi supplémentaire.

UEL'INRIA mène des travaux sur la planification collaborative dans la même direction, positionnant la recherche française pour contribuer à des solutions de co-manutention adaptatives qui pourraient bénéficier aux intégrateurs industriels européens à moyen terme.

RecherchePaper
1 source
Mixed-Initiative : le travail d'équipe humain-robot en situation de sous-optimalité avec adaptation bayésienne en ligne
2arXiv cs.RO 

Mixed-Initiative : le travail d'équipe humain-robot en situation de sous-optimalité avec adaptation bayésienne en ligne

Le travail, publié en version mise à jour sur arXiv (2403.16178v2) sous le titre "Mixed-Initiative Human-Robot Teaming under Suboptimality with Online Bayesian Adaptation", s'attaque à un biais courant dans la recherche en collaboration homme-robot: la plupart des modèles existants supposent qu'au moins un des deux partenaires, humain ou machine, agit de façon quasi optimale. Or, dans les situations réelles, humains comme agents autonomes ne disposent souvent que d'une connaissance partielle de l'environnement et agissent tous deux de manière sous-optimale, avec des capacités asymétriques. Les auteurs développent une approche bayésienne en ligne permettant à un robot d'inférer, pendant une tâche de décision séquentielle, la propension de son partenaire humain à suivre ses suggestions d'assistance, puis d'ajuster en conséquence son style d'intervention. Des études utilisateurs viennent étayer la méthode: les préférences des participants et la performance globale de l'équipe varient nettement selon le degré d'initiative pris par le robot, et l'approche proposée améliore la performance objective de l'équipe (p<.001), ainsi que des mesures subjectives comme la confiance envers le robot (p<.001) et la volonté de suivre ses recommandations (p<.001). Pour les concepteurs de systèmes homme-machine, la portée dépasse le cadre académique: cela suggère qu'un cobot ou un assistant robotique ne devrait pas se contenter d'exécuter un plan jugé optimal, mais apprendre en continu à quel point son opérateur humain lui fait confiance et adapter son niveau d'intervention en conséquence, une approche dite "mixed-initiative" où l'initiative de l'action bascule dynamiquement entre les deux parties. C'est un argument concret contre les démonstrations de laboratoire où l'humain est scripté pour se comporter de façon idéale, et un pas vers des architectures de collaboration plus robustes pour l'industrie, la logistique ou l'assistance, où l'imprévisibilité et les erreurs humaines sont la norme plutôt que l'exception. Le papier s'inscrit dans un courant de recherche en robotique interactive qui cherche à dépasser les hypothèses simplificatrices des modèles de théorie des jeux ou d'apprentissage par renforcement multi-agents, généralement testés entre agents artificiels supposés rationnels. En repositionnant l'humain comme partenaire imparfait plutôt que comme oracle de référence, ce travail rejoint les efforts plus larges sur l'adaptation en ligne et l'inférence de préférences dans les systèmes homme-robot, un axe amené à prendre de l'importance à mesure que les robots collaboratifs sortent des environnements contrôlés pour opérer aux côtés d'opérateurs aux compétences et à la disponibilité variables.

RecherchePaper
1 source
Reconnexion spatio-temporelle pour réseaux multi-robots via des CBFs à temps prescrit adaptatif
3arXiv cs.RO 

Reconnexion spatio-temporelle pour réseaux multi-robots via des CBFs à temps prescrit adaptatif

Des chercheurs ont publié sur arXiv (ref. 2606.01526) un cadre de contrôle baptisé "adaptive prescribed-time control barrier function" (adaptive PT-CBF) pour les systèmes multi-robots. Le problème central est la gestion de la connectivité du graphe de communication : dans les déploiements réels, imposer à chaque robot de rester en permanence à portée de ses voisins est souvent incompatible avec l'efficacité opérationnelle, notamment lorsque la flotte évolue dans de grands espaces avec des portées radio limitées. Le cadre proposé permet à chaque unité de se déconnecter temporairement du réseau maillé, puis de revenir dans la plage de communication dans un délai fini, ajustable et garanti formellement. Les auteurs introduisent également un mécanisme de déclenchement de reconnexion qui pondère deux critères simultanément : l'urgence de la tâche en cours et l'urgence de la reconnexion, ce qui permet de décider de façon raisonnée à quel moment un robot doit interrompre sa mission pour rejoindre le graphe. Les résultats expérimentaux montrent une amélioration de l'efficacité des tâches avec des reconnexions respectant les délais prescrits. Ce travail s'attaque à une limitation structurelle des flottes AMR et des robots de recherche distribuée : la contrainte de connectivité permanente force souvent les robots à des trajectoires sous-optimales, réduisant le throughput global. En garantissant mathématiquement la reconnexion dans un temps fini configurable, ce cadre ouvre la voie à des politiques de déploiement plus souples sans sacrifier la cohérence de l'information au niveau de l'équipe. Pour les intégrateurs industriels, cela signifie potentiellement des architectures de flotte où des robots peuvent s'aventurer en zones de faible signal pour des tâches d'inspection ou de pick, puis revenir dans le réseau selon un budget-temps maîtrisé. Le mécanisme de déclenchement basé sur une double urgence est particulièrement pertinent pour les systèmes à contraintes temporelles (livraison, surveillance d'événement). Les control barrier functions (CBFs) sont depuis plusieurs années un outil central en robotique à sécurité critique, permettant de formuler des garanties formelles sur les contraintes d'état. Les PT-CBF, ou CBFs à temps prescrit, en sont une extension permettant de borner non seulement la satisfaction d'une contrainte, mais aussi l'horizon temporel de cette satisfaction. Ce papier s'inscrit dans un courant de recherche actif, notamment en concurrence avec des approches de consensus distribué et de communication opportuniste développées par des équipes aux États-Unis, en Europe et en Chine. Les suites naturelles incluent la validation sur des flottes physiques hétérogènes, l'extension à des topologies dynamiques et l'intégration dans des planificateurs de tâches multi-agents. Aucun partenaire industriel ni calendrier de déploiement n'est mentionné dans la prépublication.

RecherchePaper
1 source
Allocation de tâches adaptative en temps réel pour la supervision de plusieurs robots par plusieurs humains
4arXiv cs.RO 

Allocation de tâches adaptative en temps réel pour la supervision de plusieurs robots par plusieurs humains

Des chercheurs proposent, dans une prépublication arXiv (2610.00897v1), une méthode d'allocation en temps réel des tâches de supervision de robots à plusieurs opérateurs humains, qui tient compte de leur état cognitif. Le scénario visé est celui où plusieurs opérateurs télé-opèrent ponctuellement plusieurs robots pour les aider à surmonter une difficulté. L'algorithme est glouton : il cherche à minimiser la charge de travail estimée de chaque opérateur, avec une priorisation des tâches. Les robots sont affectés en fonction de la capacité de supervision courante de chaque opérateur, l'effort requis variant selon le type de tâche. Une étude utilisateur compare la méthode à une référence qui ignore les facteurs humains. Sur des intervalles de temps prédéfinis, l'approche obtient de meilleures performances et moins de signes comportementaux de fatigue. Le résumé ne fournit ni nombre de participants, ni taille des flottes, ni ampleur des gains, ni type de robots. L'enjeu concerne directement les opérations où l'autonomie reste incomplète. Beaucoup de déploiements de robots mobiles, de manipulateurs ou d'humanoïdes reposent sur un modèle « un humain pour N robots », où l'opérateur intervient quand le robot bloque. Les méthodes d'allocation existantes supposent une capacité de supervision fixe par opérateur et ignorent les variations de charge mentale et de fatigue. Le résultat est une charge déséquilibrée : certains opérateurs saturent pendant que d'autres sont sous-employés. Les auteurs présentent l'ajustement adaptatif de la capacité comme un mécanisme préventif pour les longues durées et les environnements exigeants. Pour un intégrateur ou un COO, cela déplace la question du ratio opérateurs/robots vers la qualité de l'orchestration humaine. Ce ratio conditionne le coût d'exploitation réel d'une flotte, notamment quand les VLA (modèles vision-langage-action) laissent encore une part d'interventions humaines. Les limites sont à garder en tête : l'évaluation est une étude utilisateur, sans mention de terrain industriel, et le gain est mesuré face à une référence simple. Ce travail s'inscrit dans la littérature sur la supervision multi-robot et la télé-opération partagée. Cette littérature a longtemps traité l'opérateur comme une ressource de capacité constante, alors que l'industrialisation de la logistique, de la livraison et des humanoïdes de première génération rend les pics d'exceptions et la fatigue sur de longues vacations plus gênants. Plusieurs acteurs commerciaux misent déjà sur des centres de téléassistance pour couvrir les cas limites, sans qu'on sache s'ils modulent la charge de leurs opérateurs de cette façon. Aucun déploiement, pilote ou calendrier n'est annoncé, et aucun acteur français ou européen n'est cité. Les prochaines étapes naturelles seraient une validation sur des flottes réelles, avec des mesures physiologiques ou comportementales de la fatigue en conditions de production, ainsi qu'une intégration dans les logiciels d'orchestration de flottes.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source