
Aller au contenu principal
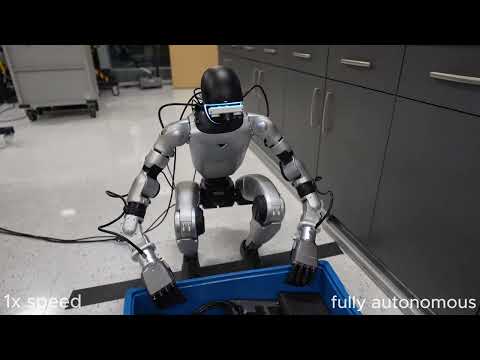
Les robots humanoïdes plient, ramassent et manipulent des objets fragiles avec plus de précision grâce à une nouvelle technologie
RechercheInteresting Engineering 

Les robots humanoïdes plient, ramassent et manipulent des objets fragiles avec plus de précision grâce à une nouvelle technologie

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Les robots humanoïdes plient, ramassent et manipulent des objets fragiles avec plus de précision grâce à une nouvelle technologie
▶ Voir sur YouTube

Des chercheurs de Carnegie Mellon University (CMU) et du Bosch Center for AI ont publié un nouveau système d'IA baptisé HTD (Humanoid Transformer with Touch Dreaming), conçu pour améliorer la manipulation d'objets par des robots humanoïdes dans des environnements à contact complexe. Le framework combine l'apprentissage par imitation avec un module de prédiction tactile, permettant au robot d'anticiper l'évolution des forces de contact et du retour haptique avant et pendant la saisie. Testé sur cinq tâches réelles, insertion d'objet en T, rangement de livres, pliage de serviette, ramassage de litière et service du thé, HTD affiche une amélioration relative de 90,9 % du taux de réussite moyen par rapport à la baseline ACT, un modèle d'imitation de référence dans le domaine. Le système repose sur une architecture dissociée : un contrôleur bas-corps entraîné par renforcement en simulation via une méthode teacher-student stabilise l'orientation du torse, la vitesse et l'équilibre, tandis que la cinématique inverse et le retargeting de main gèrent les mouvements du haut du corps et la dextérité digitale. Les représentations tactiles ne sont pas reconstruites brutes mais encodées dans un espace latent compact via un réseau cible mis à jour lentement, ce qui filtre le bruit sensoriel et améliore la stabilité de la manipulation.

Ce résultat est notable parce qu'il adresse directement l'un des verrous persistants de la robotique humanoïde : la cohabitation entre locomotion et manipulation fine sans dégradation mutuelle. La séparation architecturale bas/haut corps n'est pas nouvelle en soi, mais son intégration avec un modèle prédictif tactile dans une politique unifiée évite le recours à un pré-entraînement tactile séparé ou à un world model externe, ce qui simplifie le pipeline de déploiement. Les études d'ablation sont particulièrement instructives : incorporer le toucher comme entrée brute supplémentaire ne suffit pas, la prédiction dans l'espace latent apporte 30 % de gain relatif supplémentaire sur le raw tactile. Pour les intégrateurs qui envisagent des humanoïdes dans des cellules de manutention délicate, c'est un signal clair que la qualité de la représentation sensorielle prime sur la quantité de capteurs.

HTD s'inscrit dans une vague de travaux cherchant à combler le sim-to-real gap pour la manipulation contact-riche. Le controller bas-corps a été entraîné sur le dataset AMASS, qui fournit des mouvements humains réalistes pour perturber le torse pendant l'apprentissage, une approche de robustification déjà utilisée dans des projets comme Isaac Lab de NVIDIA ou les travaux de Stanford sur whole-body control. Dans le paysage concurrentiel, Figure (Figure 03), Physical Intelligence (Pi-0), Boston Dynamics et 1X Technologies travaillent tous sur des architectures VLA (Vision-Language-Action) pour la manipulation généraliste, mais peu publient des résultats quantitatifs sur des tâches aussi précises que l'insertion de connecteurs ou la manipulation de textiles. CMU n'a pas encore annoncé de partenariat industriel ni de calendrier de transfert vers un produit commercial, mais le Bosch Center for AI comme co-auteur suggère un intérêt applicatif concret dans l'automatisation industrielle à manipulation variable.

Impact France/UE

Le Bosch Center for AI (Allemagne) co-auteur du papier signale un intérêt applicatif concret pour l'automatisation industrielle européenne à manipulation variable, sans calendrier de transfert industriel annoncé.

À lire aussi

Vers un style de tennis professionnel pour robots humanoïdes grâce à une planification et un suivi de mouvement adaptatifs
1arXiv cs.RO 

Vers un style de tennis professionnel pour robots humanoïdes grâce à une planification et un suivi de mouvement adaptatifs

Des chercheurs ont publié le 21 août 2026 sur arXiv (référence 2608.20087v1) AdaPT, un système de planification et de suivi de mouvement adaptatif qui apprend à des robots humanoïdes à servir et échanger au tennis avec un style proche de celui des joueurs professionnels, directement à partir de vidéos de retransmissions télévisées. L'architecture est hiérarchique : un planificateur génère la trajectoire cinématique stylisée, tandis qu'un module de suivi (tracker) l'exécute en interférant le moins possible avec le plan initial. Validée en simulation, l'approche a ensuite révélé un écart important entre simulation et réel sur le robot Unitree G1, la précision du suivi se dégradant à cause de la planification autorégressive et du bruit de perception ; pour corriger cela, les auteurs ont entraîné le tracker à suivre des vitesses d'exécution randomisées et conditionné le planificateur via un adaptateur de vitesse appris. Les politiques AdaPT ont ensuite été déployées sur le robot humanoïde grand format Dobot Atom (1,7 mètre), capable de servir en conditions réelles sans capture de mouvement, avec vidéos et code publiés sur le site du projet. Ce résultat illustre concrètement la possibilité de transférer un mouvement stylisé et physiquement exigeant, appris depuis de simples vidéos, vers un robot humanoïde grande taille opérant sans motion capture ni environnement contrôlé, un enjeu central pour l'industrie face au fossé habituel entre démonstrations et performance réelle. Il faut toutefois le lire comme un résultat de recherche académique et non comme un produit commercialisé : aucune annonce de volumes, de prix ni de partenariat industriel n'accompagne la publication, et les essais restent limités en nombre. La méthode elle-même dépasse le seul tennis, puisqu'elle traite un problème plus général, générer des mouvements stylistiques complexes sans sacrifier la performance de la tâche, pertinent pour toute application humanoïde exigeant dextérité et fluidité. Ce travail s'inscrit dans une vague récente de recherches sur des humanoïdes jouant à des sports de balle, un domaine où plusieurs laboratoires ont récemment montré des frappes ou services au tennis, badminton ou ping-pong, souvent via des architectures de type VLA ou du renforcement pur. AdaPT se distingue par la combinaison d'une imitation de style issue de vidéos de diffusion et d'une architecture planificateur/tracker pensée spécifiquement pour limiter la dégradation lors du transfert simulation-réel. Les tests ont porté sur deux plateformes, le Unitree G1, standard courant en recherche sur la locomotion, et le Dobot Atom, humanoïde grand format du fabricant chinois Dobot. Les auteurs n'annoncent aucun calendrier de pilote commercial, se limitant à publier code et vidéos et à souligner des enseignements algorithmiques et d'ingénierie pour de futurs systèmes humanoïdes sportifs.

RecherchePaper
1 source
Un robot humanoïde apprend à se baisser, enjamber des objets et éviter les obstacles grâce à un nouveau système
2Interesting Engineering 

Un robot humanoïde apprend à se baisser, enjamber des objets et éviter les obstacles grâce à un nouveau système

Galbot a présenté le 13 octobre 2026 PASSAGE, un framework de recherche qui permet à un robot humanoïde de choisir comment franchir un espace encombré: enjamber un objet, se baisser sous une barrière ou se tourner de profil pour passer une ouverture étroite. Le système associe perception de l'environnement, planification de mouvement et contrôle du corps entier. Un planificateur génère de courtes séquences de mouvements, qu'un contrôleur exécute en tenant compte de la géométrie environnante. Une seule approche planificateur-contrôleur remplace les politiques séparées par type d'obstacle. Les données d'entraînement comptent 100 heures de mouvements humains, collectées en réalité virtuelle et par capture de mouvement inertielle dans 1 500 scènes virtuelles. En fonctionnement, un LiDAR fournit la perception. Le calcul tourne sur un module Nvidia Jetson AGX Orin embarqué, sans carte préétablie ni calcul déporté. Le papier annonce 98,67 % de réussite sur 750 essais simulés dans 150 scènes inédites. Ce chiffre mesure seulement l'arrivée à destination: sans aucun contact avec les obstacles, le taux tombe à 70,3 %. En conditions réelles, un Unitree G1 a réalisé 50 parcours inédits sans chute ni intervention de sécurité, dont 45 sans toucher d'obstacle. L'intérêt tient à ce que le système traite l'humanoïde comme un volume entier, tête, épaules, bras et torse compris, et non comme une paire de pieds à placer. Un robot qui passe les jambes mais heurte un plafond bas ou un chambranle reste inutilisable dans un entrepôt, un atelier ou un bâtiment conçu pour des humains. L'exécution embarquée sans carte est un point favorable pour un déploiement hors environnement contrôlé. Les chiffres demandent toutefois de la prudence. L'écart entre 98,67 % et 70,3 % montre que la locomotion en espace contraint reste fragile dès que l'on exige zéro contact, ce qui est le critère pertinent près de rayonnages, d'équipements ou de personnes. Les 50 essais physiques constituent une évaluation limitée, et rien n'établit une fiabilité généralisable. Il s'agit d'un résultat académique, pas d'un produit livré ni d'un déploiement client. Galbot, entreprise chinoise de robotique, multiplie les démonstrations de capacités de ses humanoïdes. Elle a récemment montré son robot enchaîner plus de 100 échanges lors d'un match de tennis autonome en direct, avec suivi de balle, repositionnement et retours variés. PASSAGE prolonge cette ligne en visant la navigation et la coordination du corps entier. Le choix du Unitree G1 pour la validation réelle n'est pas anodin: cette plateforme à bas coût est devenue un banc d'essai courant, et les résultats sont ainsi plus faciles à comparer ou reproduire par d'autres laboratoires. Le travail s'inscrit dans la course aux contrôleurs de corps entier appris à partir de données humaines, où se retrouvent notamment Figure, Tesla et Nvidia avec ses modèles fondation. Aucun calendrier de pilote ou d'intégration commerciale n'est mentionné. La prochaine étape à surveiller est une réduction du taux de contact, puis des tests sur le robot propre à Galbot et dans des sites industriels réels.

RecherchePaper
1 source
HiPHI : un benchmark à grande échelle pour le mouvement humain de haute précision et l'interaction avec les objets
3arXiv cs.RO 

HiPHI : un benchmark à grande échelle pour le mouvement humain de haute précision et l'interaction avec les objets

Des chercheurs ont publié HiPHI, un jeu de données de mouvement humain corps entier et d'interaction avec des objets, dépassant les 600 heures d'enregistrement, décrit dans un article déposé sur arXiv en août 2026 sous la référence 2608.16222. Construit à partir d'un pipeline de capture de mouvement optique, HiPHI atteint une précision de suivi des marqueurs spatiaux inférieure au millimètre pour le mouvement corps entier, ainsi que des trajectoires d'objets au niveau du maillage (mesh-level). Le dataset s'appuie théoriquement sur FrameNet, un cadre linguistique qui organise les primitives du mouvement humain. Les auteurs publient aussi une suite de benchmarks évaluant quatre axes : la diversité de l'espace des mouvements, l'ancrage des interactions (interaction grounding), la cohérence des objets manipulés, et les applications d'IA physique. Selon les analyses présentées, HiPHI élargit sensiblement la couverture des mouvements par rapport aux jeux de données existants, tout en conservant une fidélité élevée dans la qualité des interactions capturées. Ce travail cible un goulot d'étranglement jugé critique pour l'apprentissage de politiques robotiques humanoïdes à grande échelle : les vidéos issues d'internet, bien qu'abondantes, manquent d'états physiques précis et d'ancrage réel des interactions, tandis que les jeux de données de capture en laboratoire offrent une haute fidélité mais une couverture comportementale trop étroite. Pour les intégrateurs et laboratoires qui entraînent des modèles vision-langage-action à l'image de Pi-0 ou GR00T N2, ce type de fondation de données conditionne directement la capacité à généraliser des politiques apprises vers des tâches réelles incarnées, autrement dit le passage du simulateur au monde physique. Le papier revendique une amélioration mesurable de la diversité de mouvement, mais il s'agit à ce stade d'un benchmark académique évalué par ses propres auteurs, sans déploiement industriel ni adoption confirmée par un fabricant de robots humanoïdes. HiPHI s'inscrit dans une lignée de travaux cherchant à combler l'écart entre les grands corpus vidéo génériques et les datasets de mouvement capturés en studio, un problème documenté depuis plusieurs années dans la littérature sur l'apprentissage par imitation pour humanoïdes. Les auteurs positionnent leur contribution face aux jeux de données de mouvement existants, jugés soit trop limités en diversité soit insuffisamment ancrés physiquement, sans nommer de concurrent unique. Le texte souligne une application transversale au-delà de la robotique : les mêmes extensions de couverture pourraient aussi nourrir des modèles de prior de mouvement en infographie, utilisés notamment pour l'animation de personnages. Publié comme preprint arXiv, HiPHI demeure pour l'instant une ressource de recherche ouverte plutôt qu'un produit commercial ; sa valeur pour l'industrie dépendra de la publication effective du dataset et du code, de comparaisons indépendantes, et d'une éventuelle intégration dans des pipelines d'entraînement de robots humanoïdes commerciaux.

RecherchePaper
1 source
Robots humanoïdes : ramper, roue et backflips maîtrisés grâce aux données de mouvement et d'animation
4Interesting Engineering 

Robots humanoïdes : ramper, roue et backflips maîtrisés grâce aux données de mouvement et d'animation

Des chercheurs du RAI Institute et de Boston Dynamics ont développé ZEST (Zero-shot Embodied Skill Transfer), un framework d'apprentissage par renforcement permettant à des robots à pattes d'acquérir des mouvements agiles à partir de données de mouvement humain, en une seule phase d'entraînement plutôt qu'un réglage par tâche. Le système apprend depuis trois sources : capture de mouvement haute fidélité, vidéo simple caméra, et animation par images clés, converties en commandes robotiques par retargeting cinématique. Testé sur l'humanoïde Atlas et le quadrupède Spot de Boston Dynamics ainsi que sur le G1 d'Unitree, ZEST a reproduit des mouvements tels que reptation au sol, roulades avant, roue, breakdance, danse, tirs au but et escalade de caisses, plus un salto arrière continu et un tonneau pour Spot à partir de données d'animation. Chaque politique de contrôle a nécessité environ 10 heures d'entraînement, soit près de 7 000 itérations, sur un seul GPU NVIDIA L4, entraînée entièrement en simulation puis transférée sur le matériel réel sans réglage supplémentaire, en s'appuyant uniquement sur des capteurs proprioceptifs embarqués à l'exécution. Pour l'industrie robotique, l'intérêt tient à ce que ZEST élimine plusieurs briques habituelles des pipelines de contrôle : estimateurs d'état, longs historiques d'observation, fenêtres de référence future, calendriers de contact au sol et ingénierie poussée de récompenses propres à chaque tâche. Cela réduit potentiellement le travail d'ingénierie et de réglage requis pour chaque nouvelle compétence, un goulot d'étranglement connu du déploiement de robots humanoïdes et quadrupèdes. Le transfert réussi d'une même architecture entre un humanoïde et un quadrupède illustre une portabilité inter-morphologies rarement démontrée à ce niveau d'agilité. L'équipe reste toutefois prudente : le système n'a été validé que sur sols plats et non glissants, sans généralisation démontrée à des mouvements totalement inédits. Il s'agit donc d'une avancée de recherche publiée sous forme d'étude, avec des démonstrations en environnement contrôlé, et non d'un produit commercial déployé ou d'un pilote industriel annoncé. ZEST s'inscrit dans les travaux du RAI Institute, laboratoire de recherche lié à Boston Dynamics et centré sur le contrôle et l'apprentissage pour robots à pattes, prolongeant des efforts visant à réduire la dépendance à l'ingénierie manuelle des contrôleurs. Le framework se positionne différemment des modèles vision-langage-action comme Pi-0 de Physical Intelligence, GR00T N2 de Nvidia ou Helix de Figure, qui ciblent surtout la manipulation : ZEST vise l'agilité locomotrice et les mouvements corporels complets, du crawl militaire au salto arrière. Il ne nécessite pas d'annotations explicites de contact au sol, ce qui allège la préparation des données de démonstration. Les auteurs indiquent que les prochaines étapes porteront sur l'adaptation zero-shot et few-shot ainsi que sur l'apprentissage continu, sans calendrier ni partenaire de déploiement précisés à ce stade.

RecherchePaper
1 source