
Aller au contenu principal
Un stack d'autonomie unifié : vers un schéma directeur pour l'autonomie robotique généralisable
RecherchearXiv cs.RO 

Un stack d'autonomie unifié : vers un schéma directeur pour l'autonomie robotique généralisable
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Un stack d'autonomie unifié : vers un schéma directeur pour l'autonomie robotique généralisable
▶ Voir sur YouTube

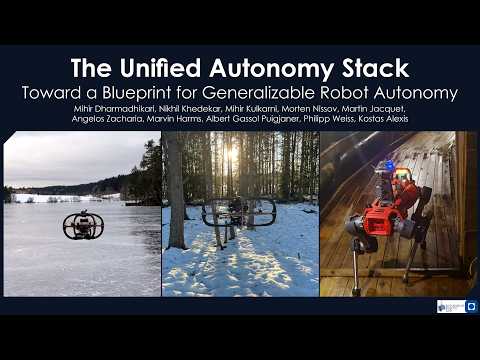
Des chercheurs du Norwegian University of Science and Technology (NTNU), au sein de leur Autonomous Robots Lab (ARL), ont publié et mis en open source un framework d'autonomie modulaire baptisé Unified Autonomy Stack (arXiv:2605.12735, mai 2025). L'architecture repose sur trois modules interdépendants : perception multimodale (LiDAR, radar, vision, centrale inertielle), planification multi-comportements, et navigation sécurisée multicouche. La fusion sensorielle s'appuie sur un graphe de facteurs pour la localisation et la cartographie simultanées (SLAM), complétée par une compréhension sémantique de la scène. La planification utilise des techniques d'échantillonnage adaptatif à différentes échelles spatiales, tandis que la sécurité de navigation combine reconstruction de carte en ligne, politiques exoceptives par deep learning et filtres de dernier recours via des fonctions de barrière de contrôle (Control Barrier Functions, CBF). Le système a été validé sur le terrain avec deux classes de robots : aériens (rotorcraft multirotors) et terrestres à pattes, dans des environnements GNSS-dégradés, enfumés, géométriquement complexes et à forte densité d'obstacles.

La contribution principale n'est pas un algorithme isolé mais une architecture système complète, validée dans des conditions réellement dégradées, ce qui reste rare dans la littérature académique. La capacité à opérer sans GPS dans des espaces à textures auto-similaires (couloirs industriels, tunnels) ou sous visibilité réduite répond directement aux besoins de l'inspection robotisée en milieux contraints : sites miniers, infrastructures énergétiques, espaces confinés. L'ouverture totale du code source, modules perception, planification et sécurité inclus, abaisse la barrière d'entrée pour les intégrateurs qui ne souhaitent pas reconstruire cette couche d'autonomie de zéro. La portabilité cross-morphologies, le même stack pour un drone et un quadrupède, est une proposition de valeur forte pour les plateformes hybrides.

L'NTNU ARL dispose d'un historique solide en navigation autonome en milieux dégradés, notamment à travers sa participation à la DARPA Subterranean Challenge. Ce projet positionne le laboratoire norvégien comme acteur open source dans un espace jusqu'ici dominé par des solutions propriétaires américaines telles que le Nav SDK de Boston Dynamics, la suite Clearpath, ou le système ANYmal d'ANYbotics. Les datasets de validation sont également mis à disposition, signal d'une ambition d'adoption communautaire active. Les extensions naturelles concerneraient l'intégration avec des couches de commande haute performance (MPC, whole-body control) et les flottes multi-robots hétérogènes.

Impact France/UE

Le framework open source de l'NTNU offre aux intégrateurs robotiques européens une alternative concrète aux suites propriétaires américaines (Nav SDK Boston Dynamics, ANYbotics) pour déployer de l'autonomie en milieux GNSS-dégradés ou contraints.

À lire aussi

GSAM : un cadre robotique sûr et généralisable pour la manipulation d'objets articulés
1arXiv cs.RO 

GSAM : un cadre robotique sûr et généralisable pour la manipulation d'objets articulés

Des chercheurs ont publié sur arXiv (référence 2605.30740) GSAM, un framework conçu pour la manipulation d'objets articulés (tiroirs, portes, robinets) par des robots de service. Le système combine quatre modules : un percepteur visuel qui extrait les paramètres cinématiques (axe de rotation, amplitude de mouvement), un raffineur basé sur un VLM fine-tuné utilisant le raisonnement par chaîne-de-pensée (CoT) pour corriger les estimations brutes, un générateur de contraintes d'interaction qui encode la géométrie de l'objet et l'évitement d'obstacles, et un planificateur cinématique qui vérifie l'atteignabilité avant exécution. Sur 50 tâches de type charnière réparties en 5 catégories d'objets et 50 configurations initiales aléatoires de l'effecteur, GSAM améliore le taux de succès de 36,0 % par rapport à la meilleure baseline existante, avec une réduction de l'écart-type de 3,1 % indiquant une meilleure consistance comportementale. Ce résultat s'attaque directement au fossé démo-réalité sur une sous-tâche souvent ignorée : les interactions avec des objets mécaniquement contraints impliquent des trajectoires curvilignes et une compréhension de la géométrie interne que ni les politiques end-to-end entraînées en simulation ni les planificateurs purement visuels ne gèrent correctement. L'usage du raisonnement CoT pour corriger des estimations cinématiques erronées plutôt que pour générer un plan de haut niveau constitue un usage pragmatique et inhabituel des VLM en robotique. Pour les intégrateurs sur des robots de service industriels ou hospitaliers, la réduction des collisions destructrices a une valeur opérationnelle directe : forcer mécaniquement un joint en production est un incident matériel, pas une métrique abstraite. Le problème de manipulation articulée est étudié depuis plusieurs années dans des équipes comme Stanford (projet Where2Act, 2021), ETH Zurich et CMU. Les approches concurrentes comprennent les frameworks VLA tels que pi0 (Physical Intelligence) ou OpenVLA, ainsi que les méthodes de perception articulée comme PARIS ou CatGrasp. GSAM se distingue en combinant explicitement un LLM pour la génération de contraintes et un VLM pour la perception raffinée, plutôt qu'une politique implicite entraînée bout-en-bout. Le travail reste un preprint arXiv non soumis à une conférence majeure (ICRA, IROS, CoRL) : les gains annoncés sont encourageants mais nécessitent une validation sur robot physique en conditions non contrôlées.

RecherchePaper
1 source
UniDomain : préentraînement d'un domaine PDDL unifié à partir de démonstrations réelles pour la planification robotique généralisable
2arXiv cs.RO 

UniDomain : préentraînement d'un domaine PDDL unifié à partir de démonstrations réelles pour la planification robotique généralisable

Une équipe de chercheurs a publié UniDomain, un cadre de pré-entraînement qui construit automatiquement un domaine PDDL (Planning Domain Definition Language) unifié à partir de démonstrations robotiques réelles, pour être ensuite appliqué à la planification de tâches en ligne. Le système ingère 12 393 vidéos de manipulation robotique, en extrait des domaines atomiques, et les fusionne en un domaine unifié comprenant 3 137 opérateurs, 2 875 prédicats et 16 481 arêtes causales. Face à une nouvelle classe de tâches, UniDomain récupère les atomes pertinents et les assemble dynamiquement en méta-domaines adaptés. Les expériences sur des tâches réelles inédites montrent des gains allant jusqu'à 58 % sur le taux de succès et 160 % sur l'optimalité des plans, comparé aux meilleures bases LLM seuls et LLM couplés à PDDL manuel, le tout en mode zéro-shot. Ce résultat s'attaque à l'un des verrous centraux de la robotique manipulatrice : la capacité à raisonner sur des séquences longues d'actions avec des contraintes implicites issues du langage et de la vision. Les LLM et VLM actuels fournissent de bons priors sémantiques, mais peinent à maintenir une cohérence causale sur des horizons temporels étendus et à ancrer les symboles dans le réel. UniDomain propose une voie médiane : extraire la structure symbolique directement depuis des démonstrations, évitant ainsi la fragilité des domaines PDDL codés à la main, souvent trop étroits pour généraliser. La généralisation compositionnelle zéro-shot, validée sur des tâches jamais vues, est ici une affirmation forte, bien que la sélection des vidéos sources et des scénarios de test mériterait une vérification indépendante pour écarter un biais de distribution. La planification symbolique robotique via PDDL est un paradigme ancien, remontant aux travaux STRIPS des années 1970, mais qui a souffert du coût élevé de l'ingénierie des domaines. Des approches récentes comme SayCan (Google), Code-as-Policies (Google Brain) ou les travaux de planification LLM de MetaAI ont tenté de contourner ce problème par la génération de code ou de plans en langage naturel, avec des résultats limités en environnements ouverts. UniDomain repositionne PDDL non plus comme une contrainte d'ingénierie mais comme un artefact appris, ce qui le rapproche conceptuellement des travaux sur l'apprentissage de modèles du monde. Les prochaines étapes naturelles incluent l'extension à la manipulation déformable, l'intégration avec des architectures VLA comme pi-0 ou GR00T N2, et une validation en environnement industriel réel, aujourd'hui absente de l'article.

RecherchePaper
1 source
Principes de l'autonomie robotique
3arXiv cs.RO 

Principes de l'autonomie robotique

Un nouveau manuel intitulé "Principles of Robot Autonomy" vient d'être publié sur arXiv (2608.03496v1, début août 2026). L'ouvrage est issu de plusieurs décennies d'enseignement à Stanford et propose une introduction unifiée aux méthodes qui composent les piles logicielles d'autonomie robotique modernes, de la perception à la planification en passant par le contrôle. Chaque chapitre est accompagné de notebooks Jupyter et d'exercices d'implémentation, pensés pour que les lecteurs construisent une intuition pratique en parallèle des fondements théoriques. Le texte s'adresse aux étudiants, ingénieurs et chercheurs qui entrent dans le domaine, et vise explicitement à faire le pont entre la robotique classique (odométrie, SLAM, planification de trajectoire, commande) et ce que les auteurs appellent l'IA physique, c'est à dire les architectures d'apprentissage qui pilotent aujourd'hui les robots déployés sur route, en entrepôt, dans les airs ou en environnement spatial. L'intérêt de ce manuel dépasse le cadre académique. Il acte un changement de statut de l'autonomie robotique, qui n'est plus seulement un sujet de recherche mais un ensemble de méthodes éprouvées sur le terrain, utilisées quotidiennement par des praticiens. Pour les ingénieurs et les décideurs B2B qui recrutent ou forment des équipes robotique, disposer d'un cadre conceptuel commun, couvrant aussi bien les fondamentaux classiques que les briques modernes d'IA physique, répond à un vrai manque : la formation universitaire peine souvent à suivre le rythme d'un secteur où les modèles VLA (vision language action) et les stacks d'autonomie évoluent plus vite que les programmes d'enseignement. Ce manuel s'inscrit dans une lignée de références historiques de la robotique universitaire, à un moment où le secteur connaît une accélération commerciale sans précédent, portée par des architectures d'IA physique et des humanoïdes déployés en usine ou en entrepôt par plusieurs acteurs industriels. Ce contexte de bascule rapide entre recherche et déploiement réel rend d'autant plus utile un ouvrage qui structure les principes fondamentaux plutôt que de courir après chaque nouvelle démonstration. Le texte ne mentionne pas de suite ou de version imprimée prévue au delà de cette publication arXiv.

RecherchePaper
1 source
Une mémoire simple à base d'agents pour les politiques robotiques généralistes
4arXiv cs.RO 

Une mémoire simple à base d'agents pour les politiques robotiques généralistes

Des chercheurs proposent SimpleARM (Simple Agentic Robot Memory), une couche de mémoire sans entraînement pour politiques robotiques généralistes gelées, décrite dans un preprint arXiv (v1). Le système fonctionne en quatre temps : à partir de l'instruction de la tâche, il détermine ce qu'il faut surveiller ; des outils perceptifs gelés maintiennent en ligne un état compact et typé ; un accès structuré ne récupère cet état que lorsqu'un sous-objectif proposé dépend de l'historique ; enfin, un ancrage dans la vue courante résout les entités rappelées avant l'exécution. L'évaluation porte sur RoboMME, un benchmark de 16 tâches de manipulation dont la réussite exige des informations qui ne sont plus visibles dans l'observation actuelle. Sur les 16 tâches et trois graines de politique, SimpleARM atteint 67,17 % de réussite moyenne, contre 44,51 % pour la meilleure base de comparaison non oracle. Des ablations appariées montrent que retirer l'état de relation, de référence, de progression ou d'itinéraire provoque de fortes chutes là où cet état est mobilisé, et épargne largement les autres tâches. L'enjeu dépasse le gain chiffré, soit environ 22,7 points. Les systèmes de mémoire visuelle actuels conservent ou compressent des observations passées, en supposant que l'historique utile se retrouve dans les images. Or le contrôle robotique dépend aussi d'un état issu de l'interaction, qu'aucune image ne représente explicitement : quel objet est lequel après avoir été déplacé, où en est la tâche, dans quel ordre exécuter une procédure. Les résultats plaident pour une mémoire conçue comme un état compact et pertinent pour la tâche, plutôt que comme un historique visuel étendu. Pour les intégrateurs et les équipes qui déploient des politiques VLA gelées, l'intérêt pratique est réel : la couche s'ajoute sans réentraînement, donc sans coût de collecte de données ni de fine-tuning. La spécificité des ablations renforce la crédibilité du mécanisme. Des réserves s'imposent toutefois : les résultats proviennent d'un benchmark, avec des tâches vraisemblablement simulées, sans preuve de déploiement réel, et l'écart avec les approches plus complexes reste à vérifier hors de RoboMME. Ce travail s'inscrit dans la montée des modèles généralistes gelés, de type VLA, qui excellent en réactivité mais restent faibles sur les tâches à longue portée dépendant du passé. Les approches concurrentes se répartissent entre conservation brute de trames, compression de contexte visuel et mémoires apprises de bout en bout, toutes exposées au même défaut : ne pas capter l'état implicite. SimpleARM adopte une orientation « agentique », où des outils spécialisés remplissent l'état plutôt que la politique elle-même. Les suites logiques seraient des tests sur robot physique, d'autres benchmarks de mémoire et une comparaison avec des politiques entraînées avec mémoire native. Le preprint n'annonce ni code, ni pilote, ni calendrier, et n'a pas encore été évalué par des pairs.

RecherchePaper
1 source