
Aller au contenu principal
Planification de mouvement en corps entier et contrôle à sécurité critique pour la manipulation aérienne
RecherchearXiv cs.RO 

Planification de mouvement en corps entier et contrôle à sécurité critique pour la manipulation aérienne

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Planification de mouvement en corps entier et contrôle à sécurité critique pour la manipulation aérienne
▶ Voir sur YouTube

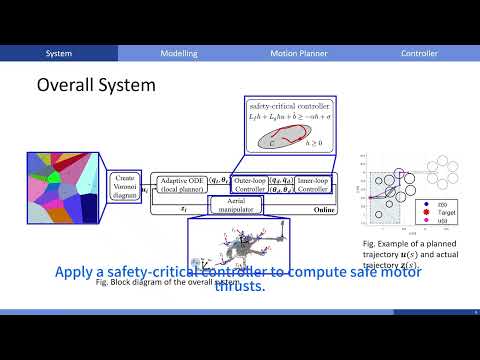
Une équipe de chercheurs propose sur arXiv (2511.02342v3) un cadre de planification de mouvement corps entier pour manipulateurs aériens : des drones multirotors équipés de bras robotiques conçus pour opérer dans des espaces encombrés. Le système repose sur une représentation par superquadriques (SQ), surfaces paramétriques différentiables qui modélisent avec précision la géométrie du véhicule, du bras embarqué et des obstacles environnants. Un planificateur à clairance maximale fusionne diagrammes de Voronoï et formulation de variété d'équilibre pour générer des trajectoires lisses, tandis qu'un contrôleur de sécurité applique simultanément les limites de poussée et l'évitement de collision via des fonctions de barrière d'ordre supérieur (high-order CBFs). En simulation, l'approche surpasse les planificateurs par échantillonnage en vitesse, sécurité et fluidité ; des expériences sur une plateforme physique réelle confirment la cohérence des performances sim-to-real.

La manipulation aérienne bute depuis longtemps sur le conservatisme des abstractions géométriques classiques : boîtes englobantes et ellipsoïdes surestiment l'encombrement du système, imposent des déviations inutiles et ferment des passages pourtant praticables. Les superquadriques résolvent ce problème en modélisant les surfaces réelles avec une fidélité géométrique fine, sans le coût computationnel des maillages. Pour les intégrateurs et équipes R&D, cela se traduit par des cycles plus courts et la capacité d'opérer dans des espaces confinés, directement pertinents pour l'inspection de structures, la maintenance en hauteur ou l'intervention en zone difficile d'accès. La validation hardware distingue ce travail de nombreuses publications restées cantonnées à la simulation, et les garanties formelles des CBF d'ordre supérieur constituent un argument de poids pour des déploiements en environnements réels.

La manipulation aérienne est un champ de recherche actif depuis une décennie, motivé par l'inspection d'éoliennes, de pylônes et d'infrastructures inaccessibles aux robots terrestres. La représentation par superquadriques, issue des travaux de Barr dans les années 1980 et revisitée par la robotique de manipulation terrestre, gagne en traction pour les contextes où la précision géométrique est critique. Parmi les équipes actives sur des problèmes voisins figurent l'ETH Zurich (ASL), le LAAS-CNRS côté français, ainsi que plusieurs groupes nord-américains et asiatiques. Ce preprint ne mentionne aucun partenaire industriel ni horizon de déploiement commercial, ce qui le positionne comme une contribution académique fondamentale avec validation expérimentale.

Impact France/UE

Le LAAS-CNRS est explicitement cité parmi les équipes actives sur des problèmes voisins ; cette contribution pourrait alimenter les travaux européens sur la manipulation aérienne pour l'inspection d'infrastructures.

Dans nos dossiers

À lire aussi

Manipulation aérienne en conditions réelles : perception embarquée, apprentissage de politiques et contrôle du corps entier
1arXiv cs.RO 

Manipulation aérienne en conditions réelles : perception embarquée, apprentissage de politiques et contrôle du corps entier

Des chercheurs présentent, dans un article publié sur arXiv (référence 2609.30521, mis en ligne le 28 septembre 2026), un système de manipulation aérienne en extérieur combinant apprentissage par imitation, estimation d'état embarquée et commande prédictive corps entier. Une Diffusion Policy, entraînée à partir de démonstrations, génère les trajectoires souhaitées de l'effecteur terminal à partir des seules observations embarquées, que traduit ensuite un contrôleur MPC "whole-body" coordonnant conjointement la plateforme volante et le bras manipulateur. Pour s'affranchir des systèmes de capture de mouvement externes habituellement requis en intérieur, la localisation repose uniquement sur une odométrie LiDAR-inertielle embarquée. Le framework a été validé sur un manipulateur aérien physique, avec exécution réussie de tâches de manipulation en extérieur, en conditions non contrôlées. Cette démonstration s'attaque à un verrou classique: la plupart des systèmes de manipulation par drone publiés jusqu'ici dépendent de salles équipées de capture de mouvement (type Vicon ou OptiTrack), ce qui cantonne les résultats au laboratoire et limite leur pertinence pour l'inspection d'infrastructures, la maintenance en hauteur ou la préhension en extérieur. En couplant une politique apprise par imitation, dans l'esprit des approches VLA qui gagnent du terrain côté robots terrestres et humanoïdes, à une commande MPC robuste aux perturbations externes comme le vent, les auteurs apportent un indice supplémentaire que l'apprentissage par démonstration peut sortir du cadre contrôlé sans sacrifier la stabilité de vol. Pour les intégrateurs qui envisagent des drones manipulateurs industriels, le travail reste toutefois un prototype de recherche validé sur un nombre limité de tâches, pas un produit commercial. La manipulation aérienne est un champ de recherche actif depuis plusieurs années, mais la quasi-totalité des démonstrations publiées restait jusqu'ici confinée à des environnements intérieurs instrumentés. L'article s'inscrit dans une tendance plus large de transfert des politiques apprises par imitation, popularisées sur des bras fixes et des humanoïdes terrestres, vers des plateformes aériennes mobiles, où l'absence d'infrastructure de localisation et les perturbations externes compliquent fortement le problème. Aucune date de déploiement industriel ni partenariat commercial n'est mentionné: il s'agit d'un travail académique dont les auteurs indiquent vouloir étendre, à l'avenir, le nombre et la diversité des tâches testées en conditions réelles extérieures.

RecherchePaper
1 source
Connectivité multi-robots : maintien et récupération pour la planification de mouvement
2arXiv cs.RO 

Connectivité multi-robots : maintien et récupération pour la planification de mouvement

Des chercheurs proposent un nouvel algorithme de planification de trajectoire pour flottes de robots, baptisé MPC-CLF-CBF, conçu pour maintenir la connectivité du réseau de communication entre robots tout en évitant les obstacles. Décrit dans une version révisée d'un article arXiv (2510.03504v3), ce planificateur en temps réel combine fonctions barrières de contrôle d'ordre élevé (CBF) et fonctions de Lyapunov de contrôle (CLF) au sein de trajectoires basées sur des courbes de Bézier, calculant simultanément trajectoire et commandes. Contrairement aux contrôleurs réactifs classiques à base de CBF, qui préservent la connectivité quand elle est déjà assurée mais se bloquent fréquemment en environnement encombré, cette approche sait aussi restaurer la connectivité depuis une configuration initialement déconnectée ou après une séparation temporaire causée par un obstacle. En simulation avec 4 à 12 robots et une densité d'obstacles de 20%, le système maintient un graphe connecté entre 95,8% et 100% du temps, contre seulement 48,9% à 61,3% pour la méthode de référence MPC-CBF, sans aucune collision observée. Les auteurs ont aussi validé l'approche physiquement sur un essaim de 8 nano-quadricoptères Crazyflie. Pour l'industrie robotique, ce travail s'attaque à un verrou concret des flottes multi-robots : maintenir un réseau de communication fonctionnel dans un environnement encombré, sans sacrifier la capacité de déplacement de la flotte. Le phénomène de blocage (deadlock) des contrôleurs CBF classiques en milieu cluttered est un problème connu et documenté dans la littérature ; le proposer comme point de comparaison chiffré, avec un écart net (quasi 100% contre environ 50-60%), donne une mesure concrète du gain. La capacité du planificateur à produire des dérivées analytiques continues le rend directement applicable aux systèmes différentiellement plats comme les drones quadrirotors, ce qui ouvre la voie à des essaims aériens plus robustes pour l'inspection, la surveillance ou la recherche-sauvetage en zones GPS-dégradées où la connectivité inter-robots est critique. Le sujet s'inscrit dans une lignée de recherche active sur les CBF appliqués à la coordination multi-agents, où la difficulté centrale reste de concilier sécurité (éviter collisions et obstacles), connectivité du réseau et progression réelle vers un objectif. La comparaison directe avec un MPC-CBF plus classique sert de baseline pour situer l'apport du couplage CLF. La validation matérielle sur banc de 8 Crazyflie, bien que modeste en échelle, apporte une preuve de concept au-delà de la simulation, un point souvent absent des publications purement théoriques sur ce sujet.

RecherchePaper
1 source
KINO : une interface à images-clés pour la planification par VLM et le contrôle du corps entier en loco-manipulation humanoïde
3arXiv cs.RO 

KINO : une interface à images-clés pour la planification par VLM et le contrôle du corps entier en loco-manipulation humanoïde

Des chercheurs présentent KINO (arXiv:2609.18869v1), un framework hiérarchique pour la loco-manipulation de robots humanoïdes qui insère des « keyframes » de mouvement comme représentation intermédiaire entre un modèle vision-langage (VLM) chargé de la planification et un contrôleur par renforcement (RL) chargé de l'exécution corps entier. Chaque keyframe encode une pose cible pour l'ensemble du corps du robot et, si nécessaire, la pose de l'objet manipulé. À partir d'une instruction en langage naturel, d'observations de la scène et d'un retour d'exécution, le VLM sélectionne successivement des keyframes pertinentes dans une bibliothèque prédéfinie ; ces keyframes sont ensuite réajustées à la scène courante pour tenir compte de la position et des dimensions des objets, avant qu'une politique conditionnée par keyframe ne génère les actions articulaires. Les auteurs introduisent une stratégie d'échantillonnage de keyframes basée sur la saillance pour l'entraînement de la politique bas niveau, qui fait passer le taux de réussite de bout en bout de 44 % à 92 % lorsque le VLM ne fournit que des keyframes éparses. Le système a été évalué sur des tâches de prise, transport et dépose d'objets, en simulation et sur un humanoïde Unitree G1, avec manipulation à une et deux mains. Ce résultat s'inscrit dans un débat central du secteur robotique : comment relier des modèles vision-langage capables de raisonner sur des instructions abstraites à des contrôleurs bas niveau capables de produire des mouvements corps entier stables. Plutôt que de miser sur une architecture VLA (vision-language-action) de bout en bout, à l'image de Pi-0, GR00T N2 ou Helix, KINO mise sur une représentation intermédiaire discrète et interprétable, ce qui pourrait faciliter le débogage et le contrôle qualité pour des intégrateurs industriels tout en limitant la fréquence des appels au VLM, coûteux en calcul. Le saut de 44 % à 92 % de succès reste toutefois une mesure obtenue en conditions contrôlées de recherche, pas un chiffre de déploiement industriel, et mériterait d'être confirmé sur des tâches plus variées. Le travail s'inscrit dans la vague de recherches académiques cherchant à rendre les humanoïdes capables de manipulation généraliste sans réentraînement massif pour chaque nouvelle scène, un axe exploré en parallèle par les architectures VLA de Physical Intelligence, NVIDIA ou Figure. Le choix du Unitree G1, plateforme humanoïde accessible et déjà utilisée dans de nombreux laboratoires, en fait un banc d'essai plutôt qu'un produit fini : aucun partenariat industriel ni calendrier de commercialisation n'est mentionné dans l'article. Les auteurs indiquent que le système généralise à des emplacements de dépose non vus pendant l'entraînement, un point clé pour juger de sa robustesse au-delà des démonstrations sélectionnées, mais le nombre d'essais et les conditions exactes de ces tests de généralisation ne sont pas précisés.

RecherchePaper
1 source
Planification en temps constant pour enchaîner mouvement sans collision et comportements de manipulation
4arXiv cs.RO 

Planification en temps constant pour enchaîner mouvement sans collision et comportements de manipulation

Des chercheurs publient, dans la version 3 d'un preprint arXiv (2512.00939), le Behavioral Constant-Time Motion Planner (B-CTMP), un planificateur de mouvement qui étend la planification à temps constant (CTMP) aux tâches de manipulation en deux étapes. Le robot exécute d'abord un mouvement sans collision vers un état d'initiation du comportement, puis déroule un comportement tel qu'une saisie ou une insertion. Le CTMP classique répond à toute requête dans un budget de temps fixé par l'utilisateur (par exemple 10 millisecondes) grâce à une phase de précalcul, dans un environnement connu à l'avance. B-CTMP change deux choses : les voisinages sont construits dans l'espace des poses d'objet plutôt que dans l'espace des configurations du robot, et la couverture est établie par certification statistique plutôt que par un simple test d'atteignabilité. Un plan n'est mis en cache que si des rollouts répétés établissent une borne inférieure de son taux de succès au-dessus d'un seuil choisi, et les auteurs démontrent que ces bornes tiennent simultanément sur tout le cache, à un niveau de confiance donné. Pour un comportement déterministe, un seul rollout suffit, ce qui redonne le test binaire du CTMP. L'évaluation porte sur trois tâches (prélèvement en rayonnage, insertion de prise, remplacement de roue), en simulation et sur robots réels. Le résumé ne donne aucun chiffre de taux de succès ni de nombre d'essais. L'enjeu est de combler un écart entre la planification de mouvement vérifiable et les comportements appris. Les compétences de manipulation riches en contacts progressent vite, mais restent cantonnées à des routines simples et scriptées, faute de garanties de sécurité, d'efficacité et de fiabilité. Le CTMP ne certifie que l'atteignabilité, un prédicat binaire, et ignore le comportement qui accomplit la tâche. Or ce comportement est de plus en plus stochastique, par exemple une politique apprise de type VLA, et aucun rollout hors ligne ne suffit à en prouver le succès. B-CTMP propose une réponse : borner statistiquement le taux de succès du comportement et garder un temps de réponse constant, y compris pour rejeter des poses d'objet infaisables. Pour un intégrateur ou un responsable de ligne, c'est le type de garantie auditable qui manque pour déployer des politiques apprises en production. Les auteurs affirment que les plans certifiés réussissent de façon constante là où les références échouent pendant l'exécution du comportement. Cette affirmation reste à vérifier sur les détails expérimentaux, notamment la diversité des poses testées et les budgets de rollouts. Ce travail prolonge la lignée du CTMP, conçu pour offrir des temps de requête bornés dans des environnements semi-structurés, typiques des cellules industrielles où les objets varient peu. Il se rapproche aussi des efforts de vérification des politiques apprises, face à la tendance dominante qui consiste à évaluer les modèles de manipulation sur des essais limités. La limite principale tient à l'hypothèse d'un environnement connu a priori et d'un monde semi-structuré : la garantie ne s'étend pas à des scènes ouvertes. Il s'agit d'une publication académique, sans produit ni déploiement annoncé. La suite logique serait de tester la méthode avec des politiques apprises plus complexes et sur des tâches plus longues, avec un cache dont la taille et le coût de précalcul restent à documenter.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source