
Aller au contenu principal
CLAW : un cadre vision-langage-action (VLA) pour la préhension robotique adaptée au poids
RecherchearXiv cs.RO 

CLAW : un cadre vision-langage-action (VLA) pour la préhension robotique adaptée au poids
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
CLAW : un cadre vision-langage-action (VLA) pour la préhension robotique adaptée au poids
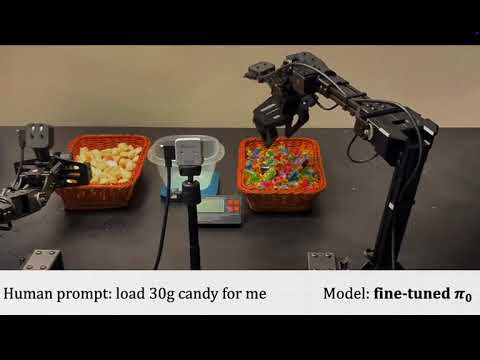
▶ Voir sur YouTube

Des chercheurs ont publié sur arXiv (arXiv:2509.14143) un framework baptisé CLAW (CLIP-Language-Action for Weight), conçu pour permettre à un robot de saisir des objets en respectant des seuils de poids définis en langage naturel. L'architecture repose sur deux composants distincts : un modèle CLIP affiné qui joue le rôle de générateur de directives symboliques en lisant en continu l'affichage numérique d'une balance, et le modèle VLA π₀ (Pi-zéro), une politique à base de flux développée par Physical Intelligence, qui intègre ces directives avec des observations caméras multi-vues pour produire des commandes motrices continues. Le système a été validé sur trois configurations expérimentales couvrant la saisie d'objets uniques et des tâches mixtes nécessitant une manipulation bi-bras. Dans toutes les conditions, CLAW surpasse à la fois π₀ brut et π₀ affiné sans le module de surveillance, sans que les auteurs ne précisent les marges de performance ni les volumes de données d'entraînement utilisés.

L'enjeu central que CLAW cherche à résoudre est une limitation structurelle des VLA actuels : entraînés de façon bout-en-bout, ces modèles peinent à respecter des contraintes numériques précises comme "arrête-toi quand le poids dépasse 500 grammes", car leur mapping observation-action est implicitement façonné par les données d'entraînement et ne dispose d'aucun mécanisme explicite de surveillance de conditions. En découplant l'évaluation de condition (symbolique, légère) de la génération d'action (continue, haute fréquence), CLAW ouvre une voie pour intégrer une logique de contrôle de procédé dans des pipelines VLA, ce qui est directement pertinent pour des applications industrielles comme le tri pondéral, le conditionnement, ou l'assemblage qualifié par masse. C'est une réponse concrète au "demo-to-reality gap" : les vidéos de démos de manipulation VLA sont souvent réalisées dans des conditions contrôlées sans contraintes mesurables ; CLAW introduit un critère d'arrêt objectif et vérifiable.

π₀ est le modèle phare de Physical Intelligence (Pi), startup fondée en 2023 par Sergey Levine et d'anciens chercheurs de Google Brain et DeepMind, qui a levé 400 millions de dollars en 2024. Le choix de π₀ comme base n'est pas anodin : c'est l'un des rares modèles VLA publiquement documentés capables de manipulation dextre généraliste. CLAW s'inscrit dans une tendance plus large de travaux qui cherchent à hybrider des couches symboliques légères avec des politiques neuronales denses, à l'image des travaux de Physical Intelligence sur le grounding multi-modal ou des approches modulaires comme OpenVLA. Aucun déploiement industriel n'est annoncé ; le travail reste au stade de la preuve de concept académique avec des setups de laboratoire, et une vidéo de démonstration est disponible sur YouTube. Les prochaines étapes naturelles seraient une évaluation sur des capteurs variés (au-delà de la balance numérique) et une généralisation à d'autres contraintes métriques comme la force ou la température.

À lire aussi

Grands modèles vision-langage-action (VLA) pour la manipulation robotique : une revue
1arXiv cs.RO 

Grands modèles vision-langage-action (VLA) pour la manipulation robotique : une revue

Une équipe de chercheurs publie sur arXiv (référence 2508.13073, troisième version) une revue systématique consacrée aux modèles Vision-Language-Action (VLA) construits sur de grands modèles vision-langage (VLM) pour la manipulation robotique. Le travail propose une taxonomie en deux familles d'architectures : les modèles monolithiques, déclinés en conception à système unique ou à double système selon le degré d'intégration entre perception et action, et les modèles hiérarchiques, qui séparent explicitement la planification de l'exécution via des représentations intermédiaires interprétables. La revue couvre l'articulation de ces modèles avec l'apprentissage par renforcement, l'optimisation sans réentraînement, l'apprentissage à partir de vidéos humaines et les modèles du monde, et recense les jeux de données et benchmarks du domaine. Les auteurs publient une page de projet mise à jour en continu sur GitHub, sous le compte JiuTian-VL. Contrairement aux annonces produits qui rythment l'actualité de la robotique humanoïde, ce travail ne présente ni déploiement ni chiffre de performance vérifié : c'est un effort de mise en ordre académique, justifié par la fragmentation et les incohérences de taxonomie qui caractérisent aujourd'hui le champ des VLA. Pour les intégrateurs et décideurs B2B, l'intérêt est méthodologique plutôt qu'opérationnel : la distinction entre architectures monolithiques et hiérarchiques donne une grille pour décrypter des offres commerciales qui se réclament du "VLA" sans détailler leur conception interne. La revue rappelle aussi que plusieurs briques restent des chantiers ouverts, mémoire, perception 4D, adaptation efficace, coopération multi-agents, ce qui tempère l'idée qu'un modèle vision-langage-action généraliste serait déjà un problème résolu à l'échelle industrielle. Les VLA se sont imposés ces dernières années comme alternative aux méthodes robotiques à base de règles, jugées incapables de généraliser à des environnements non structurés, en s'appuyant sur des VLM pré-entraînés sur de vastes corpus image-texte. Cette revue s'inscrit dans une production académique croissante qui tente de cartographier un champ où de nombreux laboratoires publient des architectures concurrentes sans convention de classification commune, d'où l'objectif affiché de résoudre les incohérences des taxonomies existantes. Le document ne cite aucun système commercial ni partenaire industriel précis ; il est pensé comme une ressource vivante, régulièrement actualisée, utile pour situer les futures annonces de VLA propriétaires, qu'elles viennent de laboratoires de recherche ou de fabricants de robots humanoïdes, par rapport à l'état de l'art académique.

RecherchePaper
1 source
Vision robotique : cartes de points centrées sur le robot pour les modèles vision-langage-action
2arXiv cs.RO 

Vision robotique : cartes de points centrées sur le robot pour les modèles vision-langage-action

Des chercheurs proposent dans un article arXiv (2607.11498v1, soumis en juillet 2026) une méthode baptisée "pointmaps robot-centriques" pour résoudre un problème structurel des modèles vision-langage-action (VLA). Ces modèles prédisent des actions robotiques à partir d'observations visuelles et d'instructions en langage naturel, mais les actions sont définies dans le repère 3D propre au robot, alors que la caméra observe la scène dans son propre repère. Ce décalage reste sans conséquence quand le point de vue de la caméra est fixe, la politique pouvant alors mémoriser une correspondance unique observation-action, mais il devient problématique à mesure que les jeux de données agrègent des démonstrations issues de configurations caméra variées. La solution proposée encode les coordonnées 3D des points de la scène, exprimées dans le repère du robot, directement dans une grille dense H x W, format identique à celui attendu par les VLA 2D pré-entraînés, ce qui permet une intégration avec un minimum de modifications architecturales. Testée sur le benchmark RoboCasa, cette approche améliore les performances de deux modèles existants, pi0.5 et SmolVLA, et surpasse des méthodes de référence basées sur le point de vue caméra ou sur une conscience 3D classique. Cette avancée touche un point sensible pour l'industrialisation des VLA à grande échelle: la généralisation à des configurations caméra non standardisées est un frein connu au déploiement sur des cellules robotiques hétérogènes, où chaque intégrateur positionne ses capteurs différemment. Les expériences sur robot réel confirment que l'avantage par rapport à une politique RGB classique s'accentue justement quand la caméra est déplacée vers un emplacement absent de l'entraînement, ce qui va dans le sens d'une meilleure robustesse au changement de point de vue, condition nécessaire pour des flottes de robots déployées avec des configurations non uniformisées, plutôt qu'un simple gain de performance en conditions contrôlées. Le travail s'inscrit dans la lignée des modèles VLA récents tels que pi-0, GR00T N2 ou Helix, qui cherchent à généraliser l'apprentissage de politiques robotiques à partir de larges corpus de démonstrations multi-plateformes. En comparant explicitement leur méthode à des approches de conditionnement par point de vue caméra et à des baselines 3D-aware, les auteurs positionnent les pointmaps comme une alternative légère à des architectures 3D plus lourdes, ouvrant la voie à des validations plus larges sur des flottes robotiques aux configurations caméra diverses.

RechercheActu
1 source
Modèles vision-langage-action (VLA) conditionnés par l'état de santé pour un contrôle robotique sensible aux pannes
3arXiv cs.RO 

Modèles vision-langage-action (VLA) conditionnés par l'état de santé pour un contrôle robotique sensible aux pannes

Une équipe de recherche publie sur arXiv (référence 2605.16056) un modèle VLA (Vision-Language-Action) capable d'adapter son comportement à la dégradation physique d'un robot, une problématique distincte des pannes de tâches habituellement ciblées par la littérature. L'approche repose sur l'injection d'un module "Health Projector" dans l'architecture VLA-Adapter : le modèle reçoit en entrée un vecteur de santé encodant l'amplitude articulaire et le couple disponible pour chaque joint. Entraîné sur 128 épisodes téléopérés collectés dans l'environnement de simulation LIBERO (benchmark Libero-Spatial), il parvient à compléter des tâches de manipulation spatiale avec des configurations de joints dégradés où le modèle de référence VLA-Adapter Libero-Spatial-Pro échoue systématiquement. Le code et le jeu de données seront prochainement disponibles sur GitHub (h-arslan/health-aware-vla). L'intérêt industriel est réel : dans les déploiements terrain, les robots accumulent des dégradations mécaniques progressives (usure articulaire, perte de couple, grippage de préhenseur) sans nécessairement déclencher d'alarme critique. Un contrôleur aveugle à cet état physique maintient ses consignes nominales et accumule les erreurs ; un modèle conditionné à la santé peut recalculer ses trajectoires à la volée. La modification proposée est présentée comme légère, ce qui suggère une intégration possible dans des pipelines VLA existants sans refonte complète. Cependant, les résultats restent limités à la simulation LIBERO avec 128 épisodes seulement, un jeu de données particulièrement restreint, et aucune validation sur robot physique n'est présentée, laissant le gap sim-to-real entièrement ouvert. Ce travail s'inscrit dans l'expansion rapide des VLA depuis 2023, portée par des modèles comme pi0 (Physical Intelligence), OpenVLA ou la famille RoboVLMs. VLA-Adapter, utilisé comme base ici, est une variante qui réduit les coûts de fine-tuning en gelant le backbone visio-langagier pour n'entraîner qu'un adaptateur léger. La résilience robotique est jusqu'ici majoritairement traitée côté contrôle bas niveau (détection de fautes, compensation par redondance articulaire) plutôt qu'au niveau de la politique visuo-langagière, ce qui rend l'angle de cette recherche original. Aucun acteur européen n'est impliqué dans cette publication. La prochaine étape logique serait une validation sur hardware réel avec des dégradations induites mécaniquement et un dataset substantiellement élargi pour crédibiliser le passage à l'échelle.

RechercheOpinion
1 source
VLA-Arena : un cadre open source pour évaluer les modèles vision-langage-action (VLA)
4arXiv cs.RO 

VLA-Arena : un cadre open source pour évaluer les modèles vision-langage-action (VLA)

Une équipe de chercheurs a publié VLA-Arena, un framework open-source de benchmark conçu pour évaluer les modèles Vision-Language-Action (VLA), ces politiques robotiques généralisées capables d'interpréter commandes en langage naturel et observations visuelles pour générer des actions motrices. La version 2 du preprint (arXiv 2512.22539v2) présente un protocole structuré autour de 170 tâches, organisées selon quatre dimensions orthogonales : sécurité (Safety), gestion des distracteurs (Distractor), extrapolation hors-distribution (Extrapolation) et planification longue portée (Long Horizon). Chaque tâche existe en trois niveaux de difficulté (L0 à L2), le fine-tuning étant exclusivement réalisé sur L0 afin de tester la capacité de généralisation. En parallèle, des perturbations linguistiques (W0-W4) et visuelles (V0-V4) s'appliquent indépendamment à chaque tâche, permettant une analyse découplée de la robustesse. Les auteurs publient également les datasets VLA-Arena-S/M/L ainsi qu'un leaderboard public. Les résultats de l'évaluation des VLA de l'état de l'art sont sévères et contre-intuitifs pour ceux qui suivent les démonstrations marketing du secteur. Les modèles testés exhibent une forte tendance à la mémorisation plutôt qu'à la généralisation réelle : leurs performances s'effondrent dès que la tâche sort légèrement de la distribution d'entraînement. La robustesse est asymétrique selon l'axe perturbé (visuel vs. linguistique), les contraintes de sécurité sont quasi-ignorées, et la composition de compétences pour les tâches longue portée reste hors de portée de tous les modèles testés. Pour les intégrateurs industriels et les équipes R&D qui envisagent de déployer des VLA en production, ces résultats constituent un signal d'alerte : le "sim-to-real gap" n'est pas résolu, et les capacités affichées en démo ne tiennent pas face à des conditions réelles variables. VLA-Arena arrive dans un contexte de prolifération rapide des VLA généralistes : Physical Intelligence (Pi-0), NVIDIA (GR00T N2), Google DeepMind (RT-2, Gemini Robotics) et OpenVLA font tous état de progrès importants, mais sur des benchmarks hétérogènes et souvent propriétaires, rendant toute comparaison directe impossible. L'absence d'un protocole d'évaluation standardisé est depuis longtemps identifiée comme le principal obstacle à la progression scientifique rigoureuse du domaine. VLA-Arena n'est pas encore un standard industriel adopté, mais sa publication en open-source avec toolchain complet (définition de tâche, évaluation automatisée, datasets) le positionne comme candidat sérieux. Les prochaines étapes dépendront de l'adoption par les équipes qui développent ces modèles, et d'une éventuelle intégration dans les pipelines de validation avant déploiement réel en atelier.

RechercheOpinion
1 source