
Aller au contenu principal
Une équipe américaine combine jumeaux numériques et VR pour améliorer les performances de robots lunaires
RechercheInteresting Engineering 

Une équipe américaine combine jumeaux numériques et VR pour améliorer les performances de robots lunaires

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Une équipe américaine combine jumeaux numériques et VR pour améliorer les performances de robots lunaires
▶ Voir sur YouTube

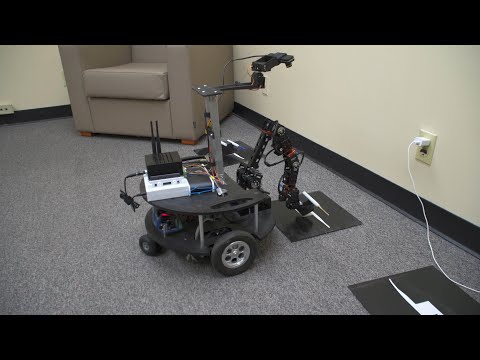
Des chercheurs de l'Université du Colorado Boulder (CU Boulder) ont développé un système combinant jumeau numérique et réalité virtuelle immersive pour entraîner les opérateurs de robots lunaires. Le dispositif s'articule autour d'Armstrong, un petit robot à trois roues équipé d'un bras articulé et d'une pince, actuellement testé en laboratoire. Son jumeau numérique, construit sous Unity et calibré pour reproduire fidèlement les dynamiques de mouvement et les interactions avec les objets, est couplé à une interface VR en vue à la première personne via les caméras embarquées. Les expérimentations réalisées montrent que les opérateurs formés d'abord dans l'environnement virtuel accomplissent les tâches de manipulation d'objets significativement plus vite et déclarent un niveau de stress nettement inférieur à ceux formés directement sur le robot physique. Le système reste à ce stade confiné au laboratoire : aucun déploiement lunaire ni test en conditions extérieures n'est annoncé.

L'enjeu est concret pour les missions lunaires à venir : sur la Lune, une erreur de manipulation peut mettre hors service un rover valant plusieurs millions de dollars, dans un environnement où la faible gravité (un sixième de celle de la Terre), les cratères, les zones d'ombre permanentes et la poussière abrasive compliquent chaque opération. La démonstration que la formation sur jumeau numérique transfère efficacement vers le matériel physique constitue une validation utile dans un domaine où ce "sim-to-real gap" reste souvent problématique. Pour les agences spatiales et les intégrateurs, cela ouvre une voie vers la standardisation des protocoles de formation sans mobiliser de hardware coûteux ni risquer d'endommager des systèmes critiques. L'équipe souligne également le potentiel pour libérer le temps EVA des astronautes, ressource particulièrement contrainte sur la surface lunaire.

Le projet s'inscrit dans la préparation à l'architecture Artemis de la NASA, qui cible un retour humain sur la Lune à partir de 2027 avec un fort volet co-opération homme-robot pour la construction d'habitats et la recherche scientifique. CU Boulder n'est pas le seul acteur sur ce créneau : le MIT, Carnegie Mellon et l'ESA développent des systèmes analogues, tandis que des entreprises comme Astrobotic ou ispace misent davantage sur l'autonomie embarquée sans interface VR opérateur. L'équipe travaille désormais à des simulations lunaires avancées intégrant le comportement de la poussière, l'éclairage rasant et le terrain irrégulier, trois facteurs jugés parmi les plus difficiles à modéliser fidèlement. Les prochaines étapes prévoient de tester la coordination de flottes de robots opérant en parallèle, capacité jugée indispensable pour les bases lunaires permanentes envisagées à l'horizon 2030-2035.

Impact France/UE

L'ESA développe des systèmes analogues de formation sur jumeau numérique pour la téléopération lunaire, ce qui pourrait créer des synergies avec les acteurs européens impliqués dans Artemis, mais sans impact direct sur l'industrie robotique française à ce stade.

À lire aussi

Un cadre pratique d'indicateurs de performance clés pour les tests sur le terrain avec plusieurs robots lunaires et planétaires
1arXiv cs.RO 

Un cadre pratique d'indicateurs de performance clés pour les tests sur le terrain avec plusieurs robots lunaires et planétaires

Une équipe de chercheurs a publié sur arXiv (référence 2601.20529, version 3) un cadre structuré d'indicateurs clés de performance (KPI) destiné à évaluer les missions multi-robots lors d'essais analogiques lunaires et planétaires. Le constat de départ : les nombreux tests de terrain simulant la prospection lunaire (ilménite, terres rares, glace d'eau) utilisent des métriques hétérogènes propres à chaque scénario, rendant toute comparaison inter-missions quasi impossible. Le cadre est dérivé de trois scénarios multi-robots représentatifs et organise les KPI autour de trois axes : efficacité (couverture de terrain, débit d'exploration), robustesse (taux de pannes, reprise après défaillance) et précision (qualité des données scientifiques collectées). Validé lors d'un test de terrain réel, il se révèle directement applicable pour les métriques d'efficacité et de robustesse ; les KPI de précision se heurtent en revanche à l'impossibilité pratique d'obtenir des données de vérité terrain fiables dans des environnements extérieurs non instrumentés. L'absence de standard commun est l'un des freins principaux au développement de la robotique planétaire : sans référentiel partagé, comparer deux systèmes multi-robots issus de plateformes et de configurations expérimentales différentes reste impossible, même lorsqu'ils visent le même objectif scientifique. Ce framework comble ce manque en reliant les métriques d'ingénierie aux objectifs de mission (ressources extractibles, couverture cartographique), ce qui est directement utile pour arbitrer entre architectures de flotte ou stratégies de coordination distribuée. La limite identifiée sur les KPI de précision est significative et honnête : mesurer la localisation absolue d'un essaim de robots en extérieur sans infrastructure de référence reste un problème ouvert, ce qui conditionne directement la fiabilité des futurs démonstrateurs ISRU (In-Situ Resource Utilization). La prospection robotique lunaire connaît une structuration accélérée sous l'impulsion du programme Artemis (NASA), des ambitions lunaires de l'ESA et d'acteurs privés comme ispace (Japon/Luxembourg) ou Astrobotic (États-Unis). Les missions analogiques terrestres sur substrats simulant le régolite sont l'outil standard avant vol, mais leur prolifération sans méthode commune a produit une littérature difficile à synthétiser et à comparer. Ce papier s'inscrit dans un mouvement de standardisation comparable à ce que l'IEEE a accompli pour les robots AMR industriels ; l'étape logique serait son adoption par des consortiums comme l'ESA-ESRIC lors de compétitions analogiques de référence, telles que l'ESRIC Space Resources Challenge, pour confirmer sa portée au-delà d'un seul contexte expérimental.

UEPotentiellement utile pour l'ESA et les consortiums européens (ESA-ESRIC) travaillant sur la robotique planétaire, notamment dans le cadre de compétitions analogiques comme l'ESRIC Space Resources Challenge.

RecherchePaper
1 source
CaP-X : un cadre pour évaluer et améliorer les agents de codage pour la manipulation robotique
2arXiv cs.RO 

CaP-X : un cadre pour évaluer et améliorer les agents de codage pour la manipulation robotique

Des chercheurs publient CaP-X, un framework open-access destiné à évaluer et améliorer les agents de type "Code-as-Policy" pour la manipulation robotique, selon un article déposé sur arXiv (2603.22435v2). Le système s'appuie sur CaP-Gym, un environnement interactif où des agents pilotent des robots en générant et exécutant du code combinant des primitives de perception et de contrôle. Sur cette base, les auteurs construisent CaP-Bench, un banc d'essai qui compare 12 modèles de langage et modèles vision-langage frontier selon différents niveaux d'abstraction, d'interaction et d'ancrage perceptif. Le travail aboutit à deux propositions concrètes : CaP-Agent0, un framework ne nécessitant aucun entraînement supplémentaire, et CaP-RL, une méthode d'apprentissage par renforcement avec récompenses vérifiables, testée en simulation puis transférée sur robots réels. L'enjeu dépasse le simple exercice académique : l'approche "code comme politique de contrôle" est présentée comme un complément aux méthodes Vision-Language-Action (VLA), très gourmandes en données, qui dominent aujourd'hui la robotique humanoïde et industrielle. CaP-Bench met en évidence une faiblesse structurelle des agents actuels, leur performance chute nettement dès que les abstractions conçues par des humains sont retirées, ce qui révèle une dépendance excessive au travail d'ingénierie préalable plutôt qu'à une véritable autonomie de raisonnement. Pour les intégrateurs et décideurs industriels, ce résultat tempère l'idée que les grands modèles suffiraient seuls à piloter des bras ou des humanoïdes sans échafaudage logiciel dédié. À l'inverse, les auteurs montrent que multiplier les tours d'interaction, le retour d'exécution structuré, la différenciation visuelle et la synthèse automatique de compétences comble une grande partie de cet écart, même sur des primitives de bas niveau. Ce travail s'inscrit dans le prolongement des recherches sur le "Code-as-Policy", initiées pour donner aux modèles de langage une interface exécutable vers le contrôle robotique, en alternative aux pipelines VLA de bout en bout. En documentant précisément où les agents actuels échouent et en ouvrant l'accès à son environnement de test, CaP-X vise à devenir une plateforme de référence pour comparer objectivement les approches futures, avant un possible passage à l'échelle sur des tâches de manipulation réelles plus complexes.

RecherchePaper
1 source
Frottement clé pour améliorer les modèles du monde des robots
3Robotics Business Review 

Frottement clé pour améliorer les modèles du monde des robots

Un nouveau papier technique propose une architecture appelée VμA pour corriger un angle mort des modèles du monde en robotique : l'absence du coefficient de frottement statique (μ) parmi les signaux de conditionnement. Aujourd'hui, la quasi-totalité des systèmes conditionnent leurs prédictions sur deux sources seulement, les images de caméras et la position des effecteurs mesurée par les encodeurs articulaires, ce qui suffit pour des tâches en espace libre mais devient insuffisant dès qu'un robot entre en contact avec un objet. Dans de nombreuses implémentations, le contact n'est même pas mesuré directement : il est déduit du courant moteur, un signal proxy éloigné de la physique réelle qui se joue au bout du doigt du gripper. Certains systèmes ajoutent des capteurs tactiles, comme ceux commercialisés par l'entreprise australienne Contactile pour équiper mains et pinces robotiques, avec des gains mesurables sur la préhension adaptative en temps réel et la correction de glissement. Mais ces capteurs restent limités à des cartes de pression, des images de déformation ou, au mieux, une distribution de force sur trois axes : ils disent qu'un contact a lieu et avec quelle intensité, pas si ce contact va tenir. C'est précisément cette lacune que VμA cherche à combler en injectant μ comme entrée de premier ordre. Le coefficient de frottement statique est la grandeur physique qui détermine si un objet saisi reste saisi, en fonction du couple de matériaux, de l'état de surface, de la température ou de la contamination. Il ne peut être ni vu par une caméra, ni déduit du courant moteur, ni reconstruit à partir d'une carte de pression. Pour l'industrie de la manipulation robotique, l'enjeu dépasse la subtilité académique : sans μ, un modèle du monde n'apprend que des corrélations statistiques entre motifs de contact et résultats observés dans ses données d'entraînement, ce qui explique pourquoi ces systèmes échouent souvent à généraliser sur des surfaces ou des objets inédits. Un modèle conditionné sur la friction change de nature, puisqu'il manipule directement la cause physique du glissement plutôt qu'un proxy appris, ce qui intéresse au premier chef les intégrateurs travaillant sur la manipulation en environnement non structuré, de la logistique à l'assemblage fin. Cette proposition s'inscrit dans la course plus large aux modèles du monde généralistes, présentés par une partie du secteur comme la prochaine étape après les architectures vision-langage-action de type Pi-0 ou GR00T N2, censées permettre à un robot de raisonner sur des situations jamais rencontrées plutôt que de mémoriser des tâches. L'argument du papier est en réalité une critique de cette trajectoire : tant que le conditionnement tactile reste incomplet, la promesse de généralisation reste largement théorique pour toute manipulation en contact riche. Les suites concrètes, à savoir une intégration de VμA sur du matériel comme les capteurs Contactile ou des essais chez des intégrateurs industriels, ne sont pas précisées dans le document source.

RecherchePaper
1 source
FlashNeRD : une dynamique neuronale de robots avec contacts multiples, conçue pour la performance
4arXiv cs.RO 

FlashNeRD : une dynamique neuronale de robots avec contacts multiples, conçue pour la performance

FlashNeRD, un travail déposé sur arXiv (2610.09130v1), propose une nouvelle génération de modèles de dynamique neuronale pour la simulation robotique. Il s'appuie sur Neural Robot Dynamics (NeRD), qui garde la détection de collision analytique mais remplace la dynamique numérique du robot par un modèle appris. Les auteurs identifient trois limites de NeRD: un gain de vitesse quasi nul face au simulateur d'origine, des contacts acceptés uniquement en des points prédéfinis, et l'absence de couplage bidirectionnel avec les objets manipulés. FlashNeRD y répond par une architecture parallèle en flux continu (« streaming »), un encodeur qui accepte les contacts où qu'ils surviennent, et un couplage bidirectionnel avec des objets simulés par des solveurs analytiques. Sur trois robots, le modèle de dynamique est jusqu'à 55 fois plus rapide qu'un NeRD optimisé, et plus précis sur de longs rollouts. Une politique de locomotion ANYmal est entraînée par PPO en 34 secondes, soit 3,8 fois plus vite qu'avec le simulateur analytique et 2,7 fois plus vite qu'avec un NeRD optimisé. Avec DIAL-MPC, une commande prédictive par échantillonnage, le robot franchit les six plateformes de test là où NeRD à contacts fixes n'en passe qu'une, pour environ la moitié du temps de planification du simulateur analytique. Des politiques de réorientation de cube entraînées avec FlashNeRD atteignent un nombre de cibles à 2 % près de celui d'une politique entraînée dans le simulateur. Les expériences portent sur cinq robots. L'enjeu est de savoir si un simulateur appris peut devenir plus qu'une curiosité académique. Jusqu'ici, la promesse d'une simulation différentiable et adaptable à des données réelles se heurtait à un obstacle: si le modèle appris n'accélère pas l'entraînement, personne n'a de raison de quitter un simulateur analytique éprouvé. Un gain de 3,8 fois sur l'apprentissage de locomotion et une planification deux fois moins coûteuse changent ce calcul pour les équipes qui entraînent des politiques par apprentissage par renforcement ou par MPC. Le résultat sur le cube est aussi significatif: un transfert à 2 % près suggère que les politiques apprises dans un simulateur neuronal conservent leur performance en manipulation riche en contacts. Il faut toutefois rester prudent: ce sont des résultats de simulation sur cinq robots, sans validation sim-to-real annoncée, et le « jusqu'à 55 fois » est un maximum obtenu sur trois robots, pas une moyenne. Ce travail prolonge NeRD, qui avait posé le principe d'un modèle appris remplaçant uniquement la dynamique du robot. Il s'inscrit dans une course où les simulateurs analytiques accélérés par GPU, dont celui qui sert ici de référence, restent la norme industrielle, tandis que les approches neuronales cherchent à s'imposer par la différentiabilité et l'adaptation aux données réelles. La suite logique serait de valider ces modèles sur du matériel physique et sur des scènes plus complexes. À ce stade, il s'agit d'une préimpression non évaluée par les pairs, sans produit ni déploiement annoncé.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source