
Aller au contenu principal
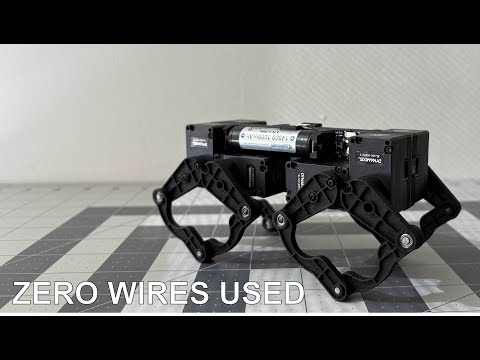
Vidéo : un robot de la taille d'une main à 8 actionneurs intelligents marche, trotte et saute
RechercheInteresting Engineering 

Vidéo : un robot de la taille d'une main à 8 actionneurs intelligents marche, trotte et saute
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Vidéo : un robot de la taille d'une main à 8 actionneurs intelligents marche, trotte et saute
▶ Voir sur YouTube

Le Q8botOne est un robot quadrupède open-source de la taille d'une paume de main, conçu par Eric Wu et destiné aux hobbyistes, étudiants, chercheurs et développeurs. Contrairement à son prédécesseur Q8bot -- qui nécessitait un assemblage manuel -- le Q8botOne est livré entièrement monté et prêt à l'emploi dès la mise sous tension. Sa mobilité dynamique repose sur huit actionneurs intelligents DYNAMIXEL de la série XL, qui animent des pattes à liaison parallèle légères, fabriquées par impression 3D Multi Jet Fusion (MJF) et équipées de joints à roulements de précision. Ces pattes permettent au robot de marcher, de trotter et de sauter, des capacités habituellement réservées à des plateformes bien plus encombrantes et coûteuses. Le système de contrôle s'articule autour d'un microcontrôleur ESP32-C3-MINI-N4, alimenté par une batterie lithium-ion avec circuit de protection intégré. L'électronique est entièrement centralisée sur un PCB personnalisé, éliminant le câblage distribué caractéristique des projets DIY classiques. Le robot sera disponible prochainement via une campagne Crowd Supply, dont le prix n'a pas encore été communiqué.

Ce qui distingue le Q8botOne dans le paysage de la robotique éducative est l'intégration verticale de sa conception : PCB central, actionneurs de série DYNAMIXEL -- habituellement réservés à des plateformes de recherche -- et châssis MJF constituent une combinaison rare à ce format. En supprimant la phase d'assemblage, le projet abaisse significativement le seuil d'entrée pour expérimenter la locomotion quadrupède, un domaine traditionnellement onéreux en temps et en matériel. L'interface UART supporte des coprocesseurs comme un Raspberry Pi avec une alimentation jusqu'à 5 V à 3 A, ouvrant la voie à des applications de vision par ordinateur, de navigation autonome ou d'IA embarquée. Un connecteur Qwiic facilite l'ajout de capteurs compatibles SparkFun et Adafruit sans câblage complexe. Ces choix d'architecture font du Q8botOne un banc d'essai crédible pour la recherche en locomotion et en contrôle, pas uniquement un gadget grand public.

Le Q8botOne s'inscrit dans la lignée du Q8bot original, dont il reprend l'approche agile et low-cost tout en franchissant un cap vers la clé-en-main. Le secteur des petits quadrupèdes open-source est animé par des projets comme le Unitree Go1 Nano ou le SpotMicro, mais peu proposent une intégration PCB aussi poussée à ce gabarit. Sur le segment éducatif, le Q8botOne se positionne face aux kits Freenove ou aux dérivés MiniCheetah, avec l'avantage d'actionneurs DYNAMIXEL reconnus pour leur fiabilité dans les labos de recherche. Les fichiers mécaniques sont développés dans Onshape, garantissant l'accessibilité à l'écosystème open-source. La campagne Crowd Supply, dont la date de lancement reste à confirmer, sera le vrai test de la demande du marché pour une plateforme quadrupède aussi compacte et prête à l'emploi.

Dans nos dossiers

À lire aussi

Vidéo : un robot inspiré de la comatule se déplace sous l'eau avec seulement deux actionneurs
1Interesting Engineering 

Vidéo : un robot inspiré de la comatule se déplace sous l'eau avec seulement deux actionneurs

Des chercheurs de North Carolina State University (NCSU) ont mis au point un robot aquatique souple capable de se déplacer en trois dimensions avec seulement deux actionneurs, là où une locomotion tridimensionnelle comparable en exige habituellement au moins six. L'engin s'inspire des comatules (« feather stars »), des invertébrés marins qui nagent et se maintiennent en position en coordonnant leurs bras. Il se compose d'un disque central, qui loge les deux actionneurs, entouré de quatre ailes élastiques dites monostables : elles fléchissent sous l'effet de l'actionnement, puis reviennent seules à leur position initiale dès que la force cesse. Trois modes de déplacement en découlent. Lorsque les deux actionneurs sont activés en cycles rapides, les ailes battent et le robot monte dans l'eau ; à cadence plus lente, il stationne (« jellyfish mode »). En n'activant qu'un seul actionneur, une aile oscille comme une nageoire caudale et propulse l'appareil vers l'avant ou l'arrière (« fish mode »). Enfin, l'alternance rapide des deux actionneurs crée des battements asymétriques qui le font pivoter sur son axe (« rotor mode »), ce qui permet de l'orienter. Les chercheurs l'ont démontré en exploration avec une caméra embarquée, et en levage d'objets, seul ou à plusieurs robots. Le résultat est surtout intéressant sur le plan de la méthode. L'équipe de Jie Yin, professeur de génie mécanique et aérospatial et auteur correspondant de l'étude, applique le principe d'« intelligence mécanique » : la structure du robot et son interaction avec l'eau déterminent une partie du comportement, ce qui réduit la charge de commande côté calculateur ou opérateur. Pour un intégrateur, passer de six actionneurs à deux signifie moins de pièces mobiles, moins d'étanchéité à gérer, moins d'électronique de pilotage et potentiellement moins de pannes, des arguments qui comptent pour des plateformes d'inspection ou de surveillance à bas coût. Il faut toutefois rester prudent : l'annonce ne fournit ni vitesse, ni profondeur d'essai, ni charge utile chiffrée, ni autonomie, ni comparaison quantifiée avec des robots sous-marins conventionnels. Les démonstrations décrites relèvent du laboratoire, sans déploiement en conditions réelles, et le robot n'est pas un produit. Ces travaux prolongent une réalisation antérieure de la même équipe, un robot aquatique inspiré de la raie manta, rapide mais dépourvu d'une aussi bonne maniabilité en trois dimensions. Ici, plutôt que d'ajouter des moteurs et des mécanismes, les chercheurs ont cherché à obtenir des degrés de liberté supplémentaires par la géométrie et l'élasticité des ailes. Ce courant de la robotique molle bio-inspirée est actif dans de nombreux laboratoires, face aux véhicules sous-marins classiques à hélices et propulseurs, plus puissants mais plus lourds et plus complexes. La prochaine étape annoncée est une version entièrement sans fil, aujourd'hui non réalisée, ainsi que des applications à explorer avec des chercheurs d'autres disciplines. Aucun calendrier de transfert industriel ni partenaire commercial n'a été communiqué, et aucun acteur français ou européen n'est cité dans ce travail.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source
Un robot monopode à jambes longues et entraînement direct atteint une hauteur de saut exceptionnelle
2arXiv cs.RO 

Un robot monopode à jambes longues et entraînement direct atteint une hauteur de saut exceptionnelle

Une équipe de chercheurs a présenté, dans un article publié sur arXiv le 28 septembre 2026, un robot sauteur monopode capable d'atteindre 7,6 mètres de hauteur en un temps d'appui au sol de seulement 190 millisecondes, ce qui en fait le saut le plus haut jamais enregistré pour un système électrique dépourvu de stockage d'énergie élastique (pas de ressort ni d'élastique). L'engin ne pèse que 281 grammes et repose sur une jambe unique, longue et légère, entraînée en transmission directe par un petit moteur électrique. L'innovation technique centrale est une transmission à enroulement de tissu offrant un avantage mécanique variable, qui maintient le moteur près de sa puissance de crête tout au long de la course tout en évitant que la jambe ne flambe sous la charge. Un module d'équilibrage placé en tête de jambe, équipé de petites hélices, contrôle l'orientation du robot au sol comme en vol, la longueur de la jambe offrant un bras de levier important pour les couples de contrôle. Le dispositif a été validé en extérieur sur des sauts verticaux, des sauts inclinés et des tests de contrôle d'attitude. Ce résultat est significatif car il montre qu'une hauteur de saut extrême peut être obtenue sans passer par le stockage élastique habituellement jugé indispensable pour ce type de performance, une hypothèse largement répandue dans la robotique de locomotion à pattes depuis des systèmes emblématiques comme Salto-1P développé à Berkeley. Pour les chercheurs en robotique mobile, cela ouvre une voie alternative fondée sur l'optimisation de la transmission mécanique plutôt que sur l'accumulation d'énergie, ce qui simplifie potentiellement la conception et réduit la masse embarquée. L'ajout d'un contrôle d'attitude par hélices pendant la phase aérienne répond également à un problème classique des robots sauteurs, la stabilisation en vol, avec un mécanisme peu coûteux en masse. Ce travail s'inscrit dans une lignée de recherches sur les robots sauteurs monopodes, un sous-domaine de la robotique à pattes où les gains de hauteur et d'efficacité énergétique restent des défis ouverts depuis des projets antérieurs à stockage élastique. Le document ne précise pas d'institution ni de financement, ni de calendrier de suite (essais en environnement non contrôlé, intégration à une plateforme mobile complète ou applications visées comme l'exploration de terrains accidentés ou les missions de reconnaissance). Il s'agit à ce stade d'un prototype de recherche démontré en extérieur, non d'un produit destiné à une commercialisation.

RecherchePaper
1 source
Vidéo : un robot maîtrise l'air hockey et bat des humains sans jamais toucher une vraie table
3Interesting Engineering 

Vidéo : un robot maîtrise l'air hockey et bat des humains sans jamais toucher une vraie table

Une équipe de trois étudiants de l'Université de la Colombie-Britannique (UBC) a développé une table de air hockey contrôlée par intelligence artificielle, capable d'affronter des joueurs humains sans avoir jamais été entraînée sur une vraie table. Le système repose sur un transfert simulation-réel (sim-to-real) : l'agent IA a été entraîné exclusivement dans un jumeau numérique haute-fidélité de la table, via une méthode d'apprentissage par renforcement appelée "soft actor-critic" (SAC), qui remplace les moteurs physiques classiques comme Unity ou Unreal pour accélérer les itérations sur des millions de parties simulées. Une fois le modèle entraîné, il a été transféré directement dans le robot physique, équipé d'une caméra aérienne à 120 images par seconde et d'un palet recouvert de bande rétroréfléchissante pour améliorer le tracking. Résultat : l'IA s'est montrée compétitive face à un adversaire humain dès le premier contact avec la table réelle, sans phase d'adaptation supplémentaire. Ce qui rend ce résultat notable, c'est la gestion explicite du "reality gap", le fossé qui sépare habituellement les performances en simulation de celles dans le monde réel. Le air hockey est un cas particulièrement difficile : le palet se déplace à grande vitesse, ses rebonds sont chaotiques, et le système doit absorber des latences caméra, des fluctuations de tension, des vibrations mécaniques et un tracking imparfait. L'équipe a répondu à ce problème par ce qu'on appelle la "domain randomization" : plutôt que de simuler une table parfaite, ils ont introduit délibérément des imperfections, rails inégaux, rebonds inconsistants, chutes d'alimentation, latence variable, pour forcer l'agent à raisonner en termes de distributions de positions probables plutôt qu'en trajectoires exactes. C'est une approche qui contredit le réflexe habituel de "nettoyer" les simulateurs, et dont les résultats suggèrent que l'imperfection contrôlée peut être un levier d'apprentissage plus robuste que la précision physique maximale. Sur le plan du contexte, ce projet étudiant s'inscrit dans un effort de recherche plus large sur les transferts sim-to-real pour les systèmes autonomes, thème central dans la robotique de manipulation, les drones et les véhicules autonomes. Il ne s'agit pas d'un produit commercialisé ni d'un déploiement industriel, mais d'une preuve de concept académique dont le code est disponible sur GitHub. Les laboratoires travaillant sur des agents de manipulation à grande échelle, comme Physical Intelligence (Pi) avec pi-0 ou des équipes universitaires spécialisées en sim-to-real, explorent des problèmes analogues sur des environnements bien plus complexes. Ce qui distingue ce travail, c'est la clarté méthodologique et la reproductibilité revendiquée : si l'approche tient à plus grande échelle, la domain randomization couplée au SAC pourrait réduire significativement les coûts et délais d'entraînement de robots autonomes dans des environnements industriels non structurés.

RecherchePaper
1 source
Vers une intelligence physique semblable à l'humain : apprentissage vision-langage-action continu pour la manipulation robotique
4arXiv cs.RO 

Vers une intelligence physique semblable à l'humain : apprentissage vision-langage-action continu pour la manipulation robotique

Des chercheurs proposent LifelongVLA, un nouveau framework d'apprentissage continu pour les modèles Vision-Language-Action (VLA) appliqués à la manipulation robotique, décrit dans un article publié sur arXiv (2607.14852). Le système s'attaque à un problème classique de l'apprentissage séquentiel chez les robots : le compromis plasticité-stabilité, c'est-à-dire la capacité d'apprendre une nouvelle tâche sans effacer les compétences acquises précédemment. Concrètement, LifelongVLA introduit un module de gating LoRA à double échelle temporelle, séparant l'adaptation en deux voies légères : un adaptateur court terme pour la plasticité (apprentissage rapide de nouvelles tâches) et un adaptateur long terme pour la consolidation stable des compétences déjà maîtrisées. Une passerelle "task-aware" arbitre entre les deux. Le framework ajoute aussi une stratégie de rejeu ("replay") stochastique et économe en mémoire cache, qui préserve des signaux de rétention équilibrés sans avoir à stocker les trajectoires complètes des tâches passées. Les auteurs rapportent des résultats supérieurs aux méthodes existantes sur un bras robotique xArm en conditions réelles, avec une expansion efficace des compétences et une meilleure rétention des comportements de manipulation déjà appris. Cette avancée cible un angle mort réel des modèles VLA actuels (type Pi-0, GR00T N2 ou Helix) : la plupart sont entraînés une fois puis figés, ou doivent être ré-entraînés intégralement pour intégrer une nouvelle tâche, ce qui est coûteux et impraticable pour un déploiement industriel évolutif. Si un robot déployé en usine ou en entrepôt doit apprendre continuellement de nouvelles manipulations sans tout ré-apprendre à chaque fois ni oublier les précédentes, une méthode d'adaptation légère et peu gourmande en mémoire comme celle-ci intéresse directement les intégrateurs et décideurs qui cherchent à réduire les coûts de ré-entraînement et les temps d'arrêt liés à la mise à jour des compétences robotiques. C'est un pas vers des flottes de robots capables de monter en compétences sur site plutôt que de dépendre d'un redéploiement complet du modèle depuis un data center. Le travail s'inscrit dans la lignée de la recherche en "continual learning" appliquée à la robotique, un domaine longtemps dominé par les architectures de vision classique avant l'essor des VLA génératifs à grande échelle. Contrairement aux approches de fine-tuning complet ou à certaines méthodes de rejeu qui nécessitent de stocker l'intégralité des trajectoires passées (coûteux en stockage et en calcul), LifelongVLA mise sur des adaptateurs LoRA légers, une technique déjà largement utilisée pour le fine-tuning efficace des grands modèles de langage, ici transposée au contrôle robotique. L'article ne mentionne pas de partenaire industriel ni de déploiement commercial ; il s'agit d'un travail de recherche académique testé sur un seul bras xArm, avec des perspectives de validation à plus grande échelle et sur des plateformes robotiques plus variées à confirmer.

RechercheActu
1 source