
Aller au contenu principal
Apprentissage de dynamiques neuronales ODE adaptées au contexte pour le contrôle robotique adaptatif
RecherchearXiv cs.RO 

Apprentissage de dynamiques neuronales ODE adaptées au contexte pour le contrôle robotique adaptatif

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Apprentissage de dynamiques neuronales ODE adaptées au contexte pour le contrôle robotique adaptatif
▶ Voir sur YouTube

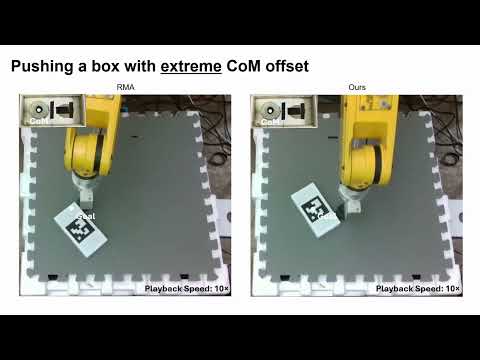
Des chercheurs ont proposé un modèle de dynamique contextuel fondé sur les équations différentielles ordinaires neuronales (Neural ODE) pour améliorer le contrôle de robots opérant dans des environnements incertains et variables. Le travail, déposé en juin 2026 sur arXiv (référence 2606.15469), cible les perturbations que les contrôleurs classiques peinent à absorber: variations des conditions de contact, effets aérodynamiques et perturbations externes imprévues. La méthode repose sur une procédure d'entraînement en deux phases: le modèle inspecte l'historique des états et des actions du robot pour inférer les facteurs environnementaux courants, sans capteurs dédiés supplémentaires. La compatibilité avec le MPC (Model Predictive Control) est intégrée dès la conception. Les validations portent sur trois plateformes distinctes: un drone quadrirotor en simulation, un robot sphérique Sphero BOLT et un bras manipulateur industriel Fanuc, ces deux derniers testés en conditions réelles.

L'enjeu central est la dérive de modèle lors du déploiement: un robot calibré en laboratoire voit ses performances se dégrader dès que l'environnement change, que ce soit un sol différent, une charge variable ou des turbulences. Par rapport aux approches récurrentes classiques (LSTM, GRU), les Neural ODE présentent un avantage structurel: elles modélisent la dynamique en temps continu, ce qui améliore la cohérence physique et simplifie l'interface avec les solveurs MPC. L'inférence du contexte depuis le seul historique actions-états, sans instrumentation additionnelle, réduit la barrière d'intégration pour les industriels. Le test sur un Fanuc, bras omniprésent en production manufacturière, ancre les résultats dans une réalité opérationnelle tangible. Point de réserve: l'article est un preprint et l'abstract ne publie aucune métrique chiffrée de performance, ce qui rend l'évaluation indépendante difficile à ce stade.

Les Neural ODE ont été introduites en 2018 par Chen et al. (NeurIPS) comme alternative aux réseaux récurrents pour modéliser des systèmes dynamiques continus. Leur application au contrôle robotique adaptatif répond à un obstacle persistant du secteur: le sim-to-real gap, qui fragilise la fiabilité des systèmes autonomes hors conditions contrôlées. Les approches concurrentes comprennent les processus gaussiens (GP) pour l'adaptation en ligne, les algorithmes méta-apprenants (MAML, PEARL) et l'identification de systèmes en temps réel. Ce travail se distingue par l'inférence contextuelle implicite, couplée nativement au MPC plutôt qu'ajoutée en couche. Le code source est ouvert sur GitHub et des démonstrations vidéo sont accessibles. La prochaine étape logique serait une validation sur des tâches de manipulation à charge variable ou un déploiement en environnement industriel non contrôlé.

Dans nos dossiers

À lire aussi

Apprentissage continu de politiques robotiques via des dynamiques neuronales variationnelles
1arXiv cs.RO 

Apprentissage continu de politiques robotiques via des dynamiques neuronales variationnelles

Des chercheurs ont publié en juin 2026 (arXiv:2606.27353) un framework d'apprentissage continu permettant à un robot de s'adapter en temps réel à des dynamiques changeantes et non observées, sans nécessiter de réentraînement complet. Le système combine un modèle de dynamique analytique (prior physique) avec un résidu neuronal entraîné à capturer les effets non modélisés. Un encodeur récurrent infère en ligne la "condition cachée" courante du robot, c'est-à-dire l'état du système non directement mesurable (charge utile variable, usure mécanique, perturbations aérologiques), à partir des trajectoires état-action récentes. Cette condition estimée pilote à la fois le modèle résiduel et la politique de contrôle. Lors de l'apprentissage, la politique est optimisée par simulation différentiable en échantillonnant un ensemble de dynamiques plausibles issues du modèle latent. Sur un quadrotor réel soumis à des vents récurrents, le système récupère une perturbation connue en environ 1 seconde, soit cinq fois plus rapidement qu'un réentraînement résiduel en ligne classique, et réduit les erreurs de vol stationnaire et de suivi de trajectoire respectivement de 65,7 % et 53,3 % par rapport aux approches d'adaptation en ligne de l'état de l'art. L'enjeu industriel est direct : la quasi-totalité des contrôleurs appris actuels sont entraînés une fois, puis déployés statiquement, comme si la dynamique du robot restait constante. En pratique, batteries qui se déchargent, charges qui changent de mission en mission, surfaces de contact qui évoluent, conditions météo variables, tout cela dégrade les performances sans mécanisme de correction. L'originalité de cette approche tient à la distinction entre "reconnaissance" et "réadaptation" : plutôt que de réajuster un modèle depuis zéro à chaque perturbation rencontrée (coûteux en données et en temps), le système reconnaît une dynamique déjà vue et l'applique immédiatement via l'encodeur récurrent. Ce paradigme est particulièrement pertinent pour les intégrateurs de drones industriels, de robots manipulateurs en logistique ou de plateformes mobiles en environnement extérieur, où les cycles de déploiement sont longs et les recalibrages manuels coûteux. Les résultats valident aussi une hypothèse clé du champ sim-to-real : qu'un prior physique structuré couplé à un résidu neuronal permet de généraliser à des conditions non vues lors de l'entraînement, à condition que ces conditions aient été préalablement "vécues" lors d'autres déploiements. Ce travail s'inscrit dans une lignée de recherches sur l'adaptation dynamique de politiques robotiques incluant la randomisation de domaine (popularisée par OpenAI Robotics dès 2018), les approches méta-learning type MAML, et les méthodes d'adaptation en ligne par processus gaussiens. Le réentraînement résiduel en ligne, utilisé comme baseline de comparaison, est une technique établie mais limitée par sa latence de convergence, problème central que ce framework adresse directement par la reconnaissance latente. L'article est à ce stade un preprint non relu par les pairs, et les expériences réelles restent limitées au quadrotor ; la généralisation à des robots à pattes ou à des bras manipulateurs industriels reste à démontrer. Aucun partenaire industriel ni calendrier de transfert technologique n'est mentionné. Les prochaines étapes probables incluent des tests sur des plateformes à dynamiques plus complexes et une validation sur des dynamiques à distribution plus large.

RecherchePaper
1 source
Cadre d'apprentissage continu pour le contrôle adaptatif de robots souples modulaires
2arXiv cs.RO 

Cadre d'apprentissage continu pour le contrôle adaptatif de robots souples modulaires

Une équipe de recherche propose un nouveau cadre de contrôle pour robots souples modulaires (Modular Soft Robots, MSR), basé sur les principes de l'apprentissage continu, selon un article publié sur arXiv le 7 juillet 2026 (arXiv:2607.06740v1). Les MSR sont des systèmes composés de plusieurs segments interconnectés, hautement déformables et reconfigurables, utilisés notamment en intervention médicale, en rééducation et en manipulation robotique. Le problème que résout ce travail est concret : jusqu'ici, changer la morphologie d'un MSR obligeait à réentraîner entièrement son contrôleur, faute de pouvoir réutiliser les connaissances acquises sur les configurations précédentes. Le framework proposé permet au contrôleur d'apprendre séquentiellement de nouvelles configurations sans oublier les précédentes, et peut aussi fonctionner de façon distribuée pour apprendre la dynamique propre de chaque module sur un robot à configuration fixe. La validation s'est faite en deux temps : des expériences de suivi de trajectoire en boucle fermée en simulation sur un robot souple actionné par tendons, puis un test sur un bras robotique souple pneumatique à trois modules, en conditions réelles. Pour l'industrie robotique, l'apport principal est méthodologique plutôt qu'un produit prêt à déployer : il s'attaque à un goulot d'étranglement bien identifié dans la robotique souple, à savoir la difficulté à faire évoluer la morphologie d'un robot sans tout reconstruire. Les MSR intéressent particulièrement les intégrateurs travaillant sur des tâches nécessitant une compliance mécanique élevée, comme la chirurgie mini-invasive ou la manipulation d'objets fragiles, où la rigidité des robots classiques est un handicap. Un contrôleur capable de s'adapter progressivement à des changements de structure, tout en activant sélectivement seulement les modules nécessaires pour atteindre une cible (ce qui réduit la charge de calcul), pourrait accélérer l'itération de conception sur ces plateformes reconfigurables, un axe encore peu mature comparé aux robots humanoïdes rigides à actionneurs classiques. Ce travail s'inscrit dans la lignée des recherches en robotique souple qui cherchent à dompter la nonlinéarité et la redondance hyper-élevée de ces systèmes, deux caractéristiques qui rendent les approches de contrôle classiques inadaptées. L'article ne mentionne pas de partenaire industriel ni de calendrier de commercialisation : il s'agit d'une contribution de recherche académique, à un stade de preuve de concept en laboratoire, dont l'étape suivante logique serait l'extension à des morphologies plus complexes ou à des tâches de manipulation réelles au-delà du suivi de trajectoire.

RecherchePaper
1 source
Apprentissage neuro-symbolique de prédicats pour un contrôle robotique sûr et sémantique
3arXiv cs.RO 

Apprentissage neuro-symbolique de prédicats pour un contrôle robotique sûr et sémantique

Des chercheurs ont publié sur arXiv (version 1, référence 2609.39594) NEUPRO, pour « Neuro-Symbolic Predicate Learning for Semantic Safe Robot Control ». Cette méthode apprend des représentations de sécurité réutilisables à partir de connaissances fournies par des humains. Les exigences de sécurité d'une tâche s'écrivent sous forme de règles symboliques lisibles. Un raisonneur différentiable les évalue, et les gradients remontent à travers ces règles jusqu'à un extracteur de caractéristiques. Celui-ci transforme les observations brutes (images, capteurs) en concepts pertinents pour la sécurité. L'extracteur reste donc « doucement » ancré dans une sémantique compréhensible par l'humain. Il permet une évaluation transparente des contraintes et se transfère d'une tâche à l'autre. Les auteurs publient aussi REASON, présenté comme le premier jeu de données de référence sur robot réel pour la spécification interprétable de la sécurité. Les expériences menées sur REASON indiquent que NEUPRO apprend des caractéristiques critiques généralisables d'une tâche à l'autre et fournit des explications explicites des violations de sécurité. Le résumé ne donne ni chiffres de performance, ni plateforme robotique, ni taille du jeu de données. L'enjeu est la certification et l'acceptation de robots dans des environnements partagés. Aujourd'hui, la sécurité est le plus souvent codée par des formulations mathématiques ou logiques opaques, ou par des fonctions de coût denses réglées à la main pour chaque tâche. Ces approches fonctionnent sur des cas précis, mais elles expliquent mal pourquoi une action est jugée sûre ou dangereuse. Elles se réutilisent aussi difficilement d'une application à l'autre. Pour un intégrateur ou un responsable sécurité, une règle lisible et auditable vaut davantage qu'un score de coût inexplicable. Cela vaut en particulier face aux exigences de traçabilité des normes industrielles et du règlement européen sur l'IA. La transférabilité entre tâches pourrait aussi réduire le coût de ré-spécification de la sécurité à chaque nouveau déploiement. Il faut toutefois rester prudent. Il s'agit d'un préprint non évalué par des pairs, sans comparaison chiffrée publique avec les méthodes de référence. Le caractère « doux » de l'ancrage sémantique signifie aussi que la fidélité des concepts appris n'est pas garantie. Ces travaux s'inscrivent dans la montée des approches neuro-symboliques en robotique. Elles cherchent à combiner la perception apprise des réseaux de neurones et le raisonnement explicite de la logique. Elles répondent à la fragilité des politiques de bout en bout et des modèles vision-langage-action (VLA), dont le comportement reste difficile à borner. Les concurrents sont multiples : les fonctions de barrière de contrôle (control barrier functions), l'apprentissage par renforcement sous contraintes, la logique temporelle et les filtres de sécurité fondés sur des modèles de langage. La suite dépendra de la publication de REASON et du code, qui permettra de reproduire les résultats. Il faudra aussi voir s'ils tiennent sur d'autres robots, hors du laboratoire, et face à des contraintes de sécurité temps réel.

UEUne sécurité robotique lisible et auditable pourrait faciliter la conformité aux exigences de traçabilité du règlement européen sur l'IA et des normes industrielles.

RecherchePaper
1 source
Analyse de l'apprentissage par renforcement profond en continu pour l'apprentissage adaptatif en robotique
4arXiv cs.RO 

Analyse de l'apprentissage par renforcement profond en continu pour l'apprentissage adaptatif en robotique

Des chercheurs publient sur arXiv (référence 2609.28807, soumission nouvelle) une étude qui livre la première analyse de l'apprentissage par renforcement profond en flux comme cadre d'apprentissage continu adaptatif pour la robotique. Contrairement à l'approche dominante, qui consiste à réentraîner hors ligne un modèle sur un jeu de données élargi après une phase de pré-entraînement, la méthode testée met à jour la politique neuronale en continu, à partir de chaque nouvelle expérience, en s'inspirant du fonctionnement de l'apprentissage biologique. Les expériences principales portent sur la locomotion d'un robot quadrupède : avec certains optimiseurs et des techniques de limitation de la perte de plasticité, la politique s'adapte rapidement en ligne à des changements imprévus touchant le robot lui-même, son environnement ou ses objectifs. Elle surpasse les méthodes batch on-policy classiques et améliore le taux de réussite des tâches jusqu'à 90% par rapport à la politique simplement pré-entraînée. Des évaluations complémentaires sur des tâches de manipulation robotique, menées sur une morphologie différente, montrent que ces gains se retrouvent partiellement, avec des limites de stabilité et de performance. Pour l'industrie robotique, ce travail apporte une première preuve empirique qu'un apprentissage en flux, sans réentraînement batch hors ligne massif, peut permettre à un robot déjà déployé de s'adapter à des situations non anticipées lors de la collecte de données initiale, un scénario courant pour les intégrateurs confrontés à des changements d'environnement, à l'usure matérielle ou à des objectifs de mission évolutifs. Cela remet en question l'hypothèse dominante du secteur selon laquelle la robustesse passe nécessairement par l'élargissement continu des jeux de données d'entraînement hors ligne, et suggère une voie alternative pour réduire le coût et la latence de mise à jour des politiques embarquées, un enjeu clé alors que les acteurs des humanoïdes et des robots mobiles autonomes cherchent à généraliser leurs modèles au-delà des scénarios démontrés en laboratoire. Le fait que les gains observés en locomotion quadrupède ne se transposent que partiellement à la manipulation souligne toutefois que la généralisation entre morphologies reste un problème ouvert, ce qui tempère tout enthousiasme prématuré côté commercialisation. Le papier s'inscrit dans un courant de recherche récent ayant démontré la faisabilité technique du deep RL en flux, où chaque mise à jour du réseau utilise uniquement la dernière expérience collectée plutôt qu'un lot de données rejouées, sans qu'aucun travail antérieur n'ait validé cette approche comme cadre viable d'apprentissage continu pour adapter des politiques robotiques à des changements non vus. Les auteurs positionnent explicitement leur contribution comme la première étude de ce type appliquée à la robotique, en s'appuyant sur une phase de pré-entraînement suivie d'une adaptation en ligne. L'étude se conclut par une discussion des limites, notamment les problèmes de stabilité observés en manipulation, et par des pistes pour les futurs systèmes de robot learning continu, sans annoncer de calendrier de déploiement ni de partenariat industriel.

RecherchePaper
1 source