
Aller au contenu principal
Un aéronef à rotors basculants doté d'une pince pour tâches de contact stables par ancrage environnemental
RecherchearXiv cs.RO 

Un aéronef à rotors basculants doté d'une pince pour tâches de contact stables par ancrage environnemental

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Un aéronef à rotors basculants doté d'une pince pour tâches de contact stables par ancrage environnemental
▶ Voir sur YouTube

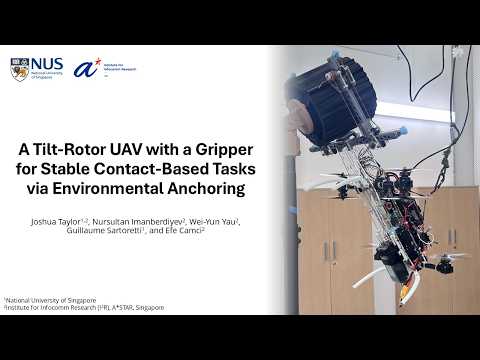
Des chercheurs ont présenté un nouveau type de drone conçu pour ancrer physiquement sa base dans son environnement afin de réaliser des tâches de contact stables, selon une publication arXiv du 1er août 2026 (2608.01736v1). La plateforme combine un multirotor à rotors inclinables, capable de découpler le tangage du mouvement d'avancement pour maintenir un vol stationnaire stable même à des angles de tangage non nuls, et une pince prismatique sous-actionnée entraînée par câbles, dotée d'une compliance mécanique lui permettant de s'adapter à des géométries irrégulières pour s'agripper à une structure. Les essais en vol sur robot réel montrent que cet ancrage réduit de plus de 95 % l'erreur quadratique moyenne (RMSE) de dérive positionnelle par rapport à un vol libre de référence, y compris dans des conditions venteuses. Une fois ancré, le système résiste à des forces de réaction longitudinales allant jusqu'à 75 newtons tout en conservant une pose stable, et sa dérive positionnelle ne dépasse jamais 3 millimètres sur l'ensemble des géométries et orientations de cibles testées.

Cette avancée s'attaque à une limite structurelle des drones classiques: leur instabilité dès qu'ils entrent en contact physique avec une surface, ce qui restreint aujourd'hui leur usage à l'observation à distance plutôt qu'à l'intervention directe. En transformant un aéronef en plateforme de travail temporairement fixe, cette approche ouvre la voie à des tâches nécessitant une force et une précision impossibles en vol libre, comme le perçage ou l'installation de capteurs. Pour les intégrateurs industriels et les opérateurs d'inspection d'infrastructures, cela représente une alternative crédible aux nacelles élévatrices ou aux interventions humaines en zones difficiles d'accès, à condition que la robustesse démontrée en essais contrôlés se confirme sur le terrain.

Le papier s'inscrit dans le champ plus large de la manipulation aérienne, où plusieurs équipes de recherche explorent des mécanismes de perchage ou d'ancrage pour stabiliser les drones lors d'interactions physiques. Les auteurs présentent leurs résultats comme une preuve de viabilité plutôt qu'un produit commercial: ils citent explicitement comme applications futures l'échantillonnage de la santé des arbres par forage et l'installation de capteurs en environnements difficiles d'accès, sans annoncer de calendrier de déploiement ni de partenaire industriel à ce stade.

À lire aussi

Un cadre d'apprentissage autonome en boucle fermée piloté par LLM pour robots confrontés à des tâches inédites en environnement ouvert
1arXiv cs.RO 

Un cadre d'apprentissage autonome en boucle fermée piloté par LLM pour robots confrontés à des tâches inédites en environnement ouvert

Une équipe de recherche a publié le 22 avril 2026 sur arXiv (référence 2604.22199) un framework d'apprentissage autonome en boucle fermée piloté par LLM, conçu pour permettre à des robots d'intégrer durablement de nouvelles compétences sans recourir indéfiniment à des modèles de langage externes. Le principe central : lorsqu'un robot rencontre une tâche absente de sa bibliothèque locale de méthodes, il déclenche un processus structuré dans lequel le LLM joue le rôle de raisonnement de haut niveau (analyse de tâche, sélection de modèle candidat, planification de collecte de données, organisation de la stratégie d'exécution). Le robot apprend ensuite à partir de sa propre exécution ou par observation active de comportements externes réussis, effectue un entraînement quasi-temps-réel, et consolide le résultat validé dans sa bibliothèque locale pour toute réutilisation future. Les résultats expérimentaux montrent une réduction du temps moyen d'exécution de 7,7772 s à 6,7779 s, et surtout une chute du nombre moyen d'appels LLM par tâche de 1,0 à 0,2 dans les scénarios de ré-exécution répétée -- soit 80 % de dépendance au LLM éliminée sur les tâches déjà apprises. L'intérêt industriel de cette approche est d'ordre économique autant que technique. Les architectures actuelles de robotique généraliste (VLA, agents LLM embarqués) génèrent des coûts d'inférence récurrents et des latences incompatibles avec des déploiements à l'échelle en environnement de production. En construisant un savoir local cumulatif à partir d'interactions réussies, ce framework agit comme un mécanisme de compilation implicite : les appels LLM coûteux disparaissent au fil des répétitions. C'est une réponse directe au reproche souvent adressé aux systèmes fondation : leur dépendance permanente au cloud pour des décisions qui devraient devenir réflexes. Ce travail s'inscrit dans une tendance de recherche active autour de l'adaptation continue des robots en monde ouvert, en concurrence avec des approches comme l'apprentissage few-shot en ligne (RT-2, OpenVLA) ou les architectures de mémoire hiérarchique explorées chez Physical Intelligence (pi0) et chez Figure AI. La distinction clé ici est la boucle fermée entre observation, entraînement local et pruning des dépendances externes, une piste encore peu exploitée à l'échelle réelle. Les auteurs ne citent pas de partenaire industriel ni de déploiement terrain : il s'agit pour l'heure d'une preuve de concept académique, dont la robustesse en environnement non contrôlé reste à démontrer.

RechercheOpinion
1 source
Apprentissage d'un contrôle de bout en bout pour le vol omnidirectionnel de quadrirotors à rotors inclinables suractionnés
2arXiv cs.RO 

Apprentissage d'un contrôle de bout en bout pour le vol omnidirectionnel de quadrirotors à rotors inclinables suractionnés

La communauté robotique aérienne franchit une étape avec un article publié sur arXiv (référence 2602.21583, version 2), qui propose un cadre d'apprentissage par renforcement (RL) de bout en bout pour le contrôle omnidirectionnel de quadrirotors surdimensionnés à rotors orientables. Ces plateformes combinent une actionnement hybride, rotors sans balais et articulations rotatives, ce qui leur confère plus de degrés de liberté qu'un quadrirotor classique mais complique fortement le transfert simulation-réel. Le système associe une simulation au niveau actionneur à une architecture acteur-critique asymétrique pour atteindre des poses cibles en 6D, en transformant directement une pose visée en commandes de rotors et d'articulations. Pour fiabiliser le passage du simulateur au matériel réel, les chercheurs combinent identification du système et randomisation de domaine limitée mais physiquement ancrée. La politique entraînée est déployée en zero-shot sur un drone physique et testée en vol stationnaire par points de passage, sous perturbations externes, avec charge utile variable et en suivi de trajectoire, complétée par des essais simulés de configurations singulières d'allocation. Comparée à une base de référence NMPC (commande prédictive non linéaire), état de l'art pour ce type d'actionnement couplé, la politique RL n'égale pas sa précision de position en régime stationnaire, mais affiche une erreur d'orientation plus homogène, des transitions de pose plus rapides et une charge de calcul embarquée réduite. Pour les intégrateurs et ingénieurs du secteur, ce résultat répond à une question ouverte: le RL au niveau actionneur, déjà validé sur des quadrirotors conventionnels pour un vol agile et robuste, peut aussi fonctionner sur des architectures à rotors orientables plus complexes, réputées plus difficiles à transférer du simulateur au réel. Le compromis observé, moins de précision statique contre moins de calcul embarqué et plus de réactivité, ouvre des pistes concrètes pour des drones à bas coût de calcul destinés à l'inspection ou à la manipulation aérienne. Le travail s'inscrit dans la continuité des succès du RL sur les quadrirotors standards, où cette approche a déjà démontré sa robustesse face aux méthodes classiques de contrôle. La question du RL sur les rotors orientables restait ouverte en raison du couplage hybride rotors-articulations, jugé plus délicat à modéliser fidèlement en simulation. Cette version 2 de l'article, republiée après une première soumission, suggère un travail de consolidation méthodologique. Les auteurs positionnent explicitement leur approche face au NMPC plutôt que de la présenter comme son remplacement, et les essais de configurations singulières restant cantonnés à la simulation laissent entrevoir une validation matérielle future comme prochaine étape logique.

RecherchePaper
1 source
Exploiter les affordances entre objets pour une planification efficace des tâches à contact riche
3arXiv cs.RO 

Exploiter les affordances entre objets pour une planification efficace des tâches à contact riche

Des chercheurs proposent une nouvelle méthode de planification robotique baptisée U-TAMP (Unified Task-and-Motion Planning), détaillée dans un preprint publié le 27 août 2026 sur arXiv (référence 2608.25641v1). Le travail s'attaque à une limite connue des approches classiques de planification tâche-mouvement (TAMP), qui modélisent les objets de façon simplifiée et ignorent des propriétés physiques essentielles (matière, forme, prise possible) pour réussir des tâches impliquant des contacts complexes, comme empoigner ou poser un objet sur un autre. Les auteurs utilisent un modèle vision-langage (VLM) pour générer automatiquement des abstractions des affordances entre objets, c'est-à-dire des contraintes de préhension et de support qui décrivent comment deux objets peuvent interagir physiquement. Ces contraintes enrichissent le domaine de planification pour gérer des objets aux propriétés variables. La méthode a été testée dans des scénarios simulés de rangement de table de cuisine, et comparée à la version originale de U-TAMP ainsi qu'à un planificateur VLM de référence s'appuyant sur le sens commun pour déduire les affordances. Résultat annoncé : un taux de réussite de planification nettement supérieur et des temps de calcul réduits d'un à deux ordres de grandeur par rapport aux méthodes concurrentes. Pour les équipes de recherche en robotique manipulatrice, ce travail illustre une piste alternative à l'apprentissage de bout en bout défendu par les modèles vision-langage-action comme Pi-0 ou GR00T N2 : plutôt que de tout confier à un réseau appris sur des données, il s'agit d'injecter du sens commun physique, via un VLM, dans un moteur de planification symbolique classique, pour gagner en vitesse et en fiabilité sans sacrifier l'interprétabilité. La réduction du temps de planification est particulièrement pertinente pour les tâches longues et séquentielles typiques de l'industrie et du service à la personne. Il faut toutefois noter que ces résultats restent cantonnés à la simulation, sur un seul type de scénario domestique, sans validation sur robot réel ni indication de déploiement industriel. Le TAMP est un champ de recherche établi qui combine raisonnement symbolique et planification de mouvement continue ; ce papier s'inscrit dans la lignée d'un système U-TAMP préexistant, qu'il étend avec la brique VLM pour l'affordance. Les prochaines étapes attendues, non précisées dans l'article, seraient une validation sur plateforme physique et une extension à des tâches de manipulation plus variées que le simple rangement de table.

RecherchePaper
1 source
Accrochez-vous : le calage environnemental conditionné par la tâche pour une manipulation humanoïde forcée
4arXiv cs.RO 

Accrochez-vous : le calage environnemental conditionné par la tâche pour une manipulation humanoïde forcée

Des chercheurs présentent, dans un preprint arXiv (2609.25486), la Supporting Hand Strategy (SHS), une méthode qui permet à un robot humanoïde de s'appuyer sur l'environnement avec une main pendant qu'il exerce une force avec l'autre. Le système combine deux politiques d'apprentissage par renforcement synchronisées, guidées par une configuration d'appui optimisée selon la tâche, sans données de mouvement humain ni planification de trajectoire corps entier en temps réel. Testé sur un Unitree G1, il atteint des forces de contact exploitables jusqu'à 60 newtons, contre 13,5 newtons au maximum sans appui environnemental, avec un suivi de force nettement amélioré par rapport à une configuration d'appui générique et non spécifique à la tâche. Les mêmes politiques se généralisent à d'autres zones de tâche sans réentraînement. Ce résultat s'attaque à une limite connue des humanoïdes bipèdes : toute force exercée par un bras via un contact avec l'environnement peut déséquilibrer le robot, ce qui cantonne aujourd'hui les tâches dites forcées, comme visser, tirer, pousser ou actionner un outil, à des efforts légers. Multiplier par plus de quatre la force utilisable, sans recourir à de la téléopération humaine ni à une replanification complexe de la posture corps entier, ouvre une piste peu coûteuse pour rapprocher les humanoïdes de tâches industrielles réelles telles que l'assemblage ou la maintenance. Le résultat reste toutefois un test de laboratoire sur une seule plateforme et une tâche conditionnée : il documente un gain de capacité mesurable, pas un produit ni un déploiement. La manipulation forcée demeure un angle mort de la course aux humanoïdes, largement concentrée jusqu'ici sur la locomotion et les démonstrations de préhension fine chez des acteurs comme Figure ou Tesla avec Optimus. Le choix du Unitree G1, plateforme chinoise abordable très utilisée en recherche académique, en fait un banc d'essai courant avant un éventuel transfert vers des humanoïdes industriels plus robustes. L'approche, fondée sur du renforcement synchronisé sans capture de mouvement humain, tranche avec les méthodes par téléopération ou imitation privilégiées ailleurs et alimente le débat sur la viabilité du sim-to-real pour le contrôle corps entier. Publié en preprint, le travail n'annonce ni pilote ni calendrier de déploiement ; sa prochaine étape logique serait une validation sur des tâches industrielles concrètes et sur d'autres plateformes humanoïdes.

RecherchePaper
1 source