
Aller au contenu principal
La meilleure façon d'explorer les cratères lunaires : une boule robotique géante
RechercheIEEE Spectrum Robotics 

La meilleure façon d'explorer les cratères lunaires : une boule robotique géante
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
La meilleure façon d'explorer les cratères lunaires : une boule robotique géante
▶ Voir sur YouTube

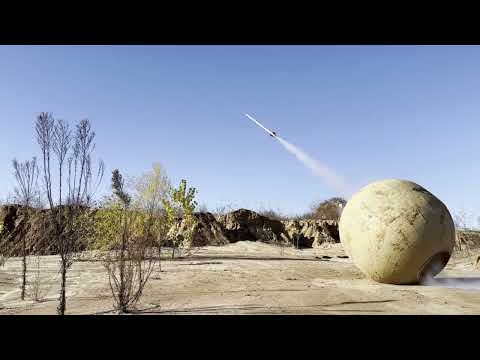
Des chercheurs du laboratoire RAD de Texas A&M University, à College Station, ont testé en février 2026, dans une carrière du centre du Texas, RoboBall III, un robot sphérique gonflable de 1,8 mètre de diamètre pour 150 kilogrammes, qui a roulé sans difficulté sur des roches, du gravier et de l'argile humide. Le projet, mené par le doctorant en génie mécanique Rishi Jangale, vise à terme l'exploration de cratères lunaires inaccessibles comme Shackleton, au pôle sud de la Lune : 21 kilomètres de diamètre, 4 kilomètres de profondeur, avec des poches en ombre permanente où la température descend à moins 240°C, contre plus de 93°C côté ensoleillé, et où se trouveraient glace d'eau et strates géologiques anciennes. RoboBall se déplace grâce à un pendule interne qui déplace son centre de masse pour faire rouler sa coque protectrice. Ces travaux sont détaillés dans un article publié dans IEEE Transactions on Field Robotics, qui présente la conception du robot, un scénario de mission lunaire encore hypothétique, et les résultats de ces premiers essais de terrain.

Cette forme sphérique répond à une contrainte opérationnelle : sur un sol lunaire à faible gravité, un rover classique risque de basculer, et la NASA exclut d'envoyer des astronautes près de cratères d'où on ne pourrait pas les extraire en cas de chute. La démonstration reste à un stade académique, entre essais en carrière terrestre et scénario de mission hypothétique, mais elle répond à une vraie lacune scientifique : aucun échantillon lunaire n'a été rapporté sur Terre depuis plus de cinquante ans, et les météorites lunaires manquent, selon la minéralogiste Sara Russell du Natural History Museum de Londres, du contexte géologique de terrain qui fait la valeur scientifique d'un prélèvement. Contrairement à un rover tenu par un câble, RoboBall n'aurait pas besoin de remonter par ses propres moyens : il pourrait collecter des échantillons au fond d'un cratère puis les renvoyer par petites fusées vers un rover resté au bord, avec un rayon d'action bien plus large.

L'idée remonte à 2003, quand Robert Ambrose, alors ingénieur robotique à la NASA et aujourd'hui responsable du laboratoire RAD à Texas A&M, a imaginé qu'une sphère gonflable, insensible au retournement et isolée thermiquement, pourrait aller là où rover à roues et astronautes ne s'aventurent pas. Un premier démonstrateur, RoboBall II, large de seulement 0,5 mètre, a été achevé en 2022 après des itérations rapides marquées par des pannes logicielles et un système de transmission trop faible pour franchir des obstacles meubles ; il aura fallu onze mois de plus pour aboutir à RoboBall III. Aucune mission lunaire n'est à ce jour programmée : le projet reste une démonstration technologique universitaire, destinée à alimenter les réflexions de la NASA en vue de futures explorations robotiques du pôle sud lunaire.

À lire aussi

RESample : un cadre robuste d'augmentation de données par échantillonnage exploratoire pour la manipulation robotique
1arXiv cs.RO 

RESample : un cadre robuste d'augmentation de données par échantillonnage exploratoire pour la manipulation robotique

Les modèles Vision-Language-Action (VLA), entraînés par apprentissage par imitation sur de vastes jeux de démonstrations, pilotent aujourd'hui la plupart des systèmes de manipulation robotique avancés. Mais ces jeux de données ne contiennent presque exclusivement que des trajectoires réussies : dès qu'un robot déployé s'écarte légèrement du scénario appris, ce décalage de distribution le pousse vers des situations d'échec pour lesquelles il n'a jamais vu d'exemple de correction. Des chercheurs proposent RESample, un cadre d'augmentation de données guidé par la couverture, qui vient combler ce trou. La méthode entraîne une fonction de couverture conservatrice capable de repérer les modes d'échec plausibles dans le monde réel mais absents des démonstrations standard, puis génère par échantillonnage exploratoire des séquences où le robot s'écarte volontairement de la trajectoire avant d'exécuter une action de récupération. Ces trajectoires synthétiques enrichissent le jeu d'entraînement initial. Sur le benchmark LIBERO et sur des tâches réelles de manipulation, RESample améliore systématiquement le taux de réussite des politiques, avec un gain absolu allant jusqu'à 12 points, pour un surcoût de données limité à 20% du jeu de départ. L'enjeu dépasse la performance brute : c'est le problème classique du "reality gap" entre démonstrations et déploiement qui est directement attaqué. Un bras robotique piloté par un VLA finit toujours, en usage réel, par dévier légèrement de sa trajectoire d'apprentissage, à cause du bruit capteur, d'un objet mal positionné ou d'une variation de lumière. Sans exemples de récupération, ces déviations s'accumulent jusqu'à l'échec complet de la tâche. En automatisant la génération de ces scénarios correctifs, plutôt qu'en s'appuyant sur du télé-opérateur humain coûteux pour les enregistrer, RESample s'attaque à un vrai goulot d'étranglement pour l'industrialisation des VLA en environnement industriel ou logistique, où la fiabilité prime sur la démonstration en conditions idéales. Ce travail s'inscrit dans une lignée de recherches récentes sur la robustesse des politiques d'imitation, aux côtés d'approches comme les corrections DAgger ou les méthodes de fine-tuning par renforcement appliquées à des modèles de type Pi-0 ou GR00T N2. La publication, une version révisée (v4) d'un article arXiv d'octobre 2025, ne mentionne pas de partenariat industriel ni de déploiement commercial: il s'agit d'un résultat de laboratoire, validé en simulation (LIBERO) et sur un nombre limité de tâches réelles, dont l'ampleur exacte n'est pas précisée dans le résumé.

RecherchePaper
1 source
Exploitation des failles : attaques adverses universelles contre les modèles vision-langage-action (VLA) en robotique
2arXiv cs.RO 

Exploitation des failles : attaques adverses universelles contre les modèles vision-langage-action (VLA) en robotique

Des chercheurs publient sur arXiv une attaque adversariale « universelle » contre les modèles Vision-Language-Action (VLA), ces réseaux de bout en bout qui fusionnent perception visuelle, compréhension du langage et génération d'actions pour la manipulation robotique. Le dispositif, baptisé Universal Adversarial Object, est une sphère dont la texture de surface a été optimisée. Posée dans le champ de vision du robot, elle dégrade nettement le taux de réussite des tâches. L'approche repose sur un cadre d'attaque à plusieurs niveaux, qui perturbe conjointement la planification de trajectoire, l'exécution de la tâche et le contrôle de l'action. Les auteurs l'ont validée en simulation et en conditions réelles sur deux modèles représentatifs, Pi0 et RDT. Le taux de réussite moyen recule de 31,2 % à 39,9 % selon le modèle, et tombe quasiment à zéro dans les scénarios complexes. Le résumé ne précise ni les tâches testées, ni le nombre d'essais, ni la plateforme matérielle, ni le niveau d'accès au modèle supposé pour l'attaquant. Ces éléments conditionnent la portée des chiffres. Pour les intégrateurs et les responsables de déploiement, le résultat touche un point que les démonstrations commerciales abordent peu. Un VLA ne se contente pas d'être fragile face à des variations de décor ou d'éclairage. Il peut être dégradé par un simple objet physique, passif et bon marché à produire, sans intrusion logicielle ni accès au réseau du robot. Le caractère « universel » est le point central : l'objet n'est pas conçu pour une scène ou une consigne donnée, ce qui rend une attaque plausible hors laboratoire. Le travail contredit l'idée implicite selon laquelle l'entraînement à grande échelle suffirait à rendre ces politiques robustes. Il pose aussi une question de sûreté fonctionnelle. Une chute de réussite de plus de 30 % reste un échec de tâche, mais un robot qui interagit avec des humains peut produire des mouvements inattendus. Ces risques sont rarement couverts par les normes de sécurité actuelles, pensées pour des automates déterministes. Il faut toutefois rester prudent : les gains annoncés viennent d'une évaluation académique, avec des tâches choisies par les auteurs. Pi0 (Physical Intelligence) et RDT (Robotics Diffusion Transformer) comptent parmi les VLA ouverts les plus utilisés dans la recherche. Ils servent de base à de nombreux travaux de fine-tuning, ce qui explique leur choix comme cibles. Cette étude s'inscrit dans une littérature croissante sur les attaques adversariales physiques, d'abord développées pour la vision par ordinateur (patchs adversariaux), puis étendues aux modèles multimodaux. Elle intervient alors que Figure, Tesla, NVIDIA et d'autres poussent des politiques VLA vers des déploiements industriels. La suite logique consistera à tester des défenses : entraînement adversarial, détection d'objets hors distribution et filtrage des entrées visuelles. Il faudra aussi vérifier si l'attaque se transfère aux modèles fermés.

RecherchePaper
1 source
You Don't Restez Pas dans la Boucle : une Boucle Robotique à Base d'Agents pour Améliorer les Politiques Robotiques
3arXiv cs.RO 

You Don't Restez Pas dans la Boucle : une Boucle Robotique à Base d'Agents pour Améliorer les Politiques Robotiques

Un article de recherche publié sur arXiv (arXiv:2608.07555v1, intitulé "You Don't Need To Stay in The Loop: An Agentic Robotics Loop for Robot-Policy Improvement") présente AgenticRobotics, une architecture de contrôle indépendante du backend pour automatiser l'amélioration des politiques robotiques. Le système transpose à la robotique l'architecture des agents de codage type Claude Code ou Codex, où un agent principal pilote la boucle pendant que des sous-agents exécutent les tâches via des outils. Ici, un contrôleur LLM dirige des workers jetables à travers des transactions entraîner-évaluer-améliorer, avec cinq briques: un objectif immuable, une mesure détenue par le contrôleur, une récupération après crash indexée par commit, une bibliothèque de compétences graduée par preuves, et un registre d'outils à surface d'appel standardisée et enregistrée. Sur la lignée testée par les auteurs, le taux de fausse promotion tombe à 0,001 par run en version durcie contre 0,005 à 0,021 en version de base, les décisions restent valides à tout moment sous arrêt optionnel, aucun effet n'est perdu ou dupliqué sous injection de pannes, et un vérificateur signé détecte les six classes de falsification d'artefacts testées. Le point de départ est que les outils robotiques (politiques entraînées, pipelines d'entraînement, collecte de données) échouent régulièrement, contrairement aux outils logiciels des agents de codage: AgenticRobotics mesure donc et enregistre la qualité de chaque outil à chaque appel, et l'expire dès que l'artefact sous-jacent change. Les auteurs précisent que le titre est une revendication opérationnelle et non une revendication de performance: l'opérateur humain peut quitter la boucle parce que la promotion des candidats est conditionnée à des preuves et que l'état du système est récupérable, pas parce que la boucle sélectionne de meilleurs checkpoints qu'un humain. Sur la lignée testée, ce n'est d'ailleurs pas le cas. Pour les intégrateurs et responsables R&D en robotique, l'intérêt n'est donc pas un gain de performance des politiques mais une réduction mesurable du risque opérationnel lors de cycles d'amélioration continue à grande échelle, une distinction utile face aux discours qui assimilent automatisation de la supervision et automatisation de la décision de qualité. Le travail prolonge explicitement les architectures d'agents de codage popularisées par Claude Code (Anthropic) et Codex (OpenAI), adaptées ici au contexte des politiques robotiques apprenantes, où les pipelines d'entraînement produisent des artefacts instables et coûteux à valider. En présentant AgenticRobotics comme un plan de contrôle indépendant du backend, les auteurs visent une architecture générique plutôt que liée à un fournisseur ou une pile logicielle unique. L'article ne mentionne ni déploiement industriel ni partenariat commercial: il s'agit d'une contribution de recherche évaluée sur une seule lignée expérimentale de politique, ce qui limite pour l'instant la portée des résultats. Les suites logiques, non détaillées dans cette publication, porteraient sur l'extension à davantage de lignées de politiques et de backends robotiques afin de confirmer la généralité des garanties de sécurité et de traçabilité mises en avant.

RecherchePaper
1 source
Un robot de tennis de table bat certains des meilleurs joueurs mondiaux : les implications majeures pour la robotique
4Robohub 

Un robot de tennis de table bat certains des meilleurs joueurs mondiaux : les implications majeures pour la robotique

Sony AI a publié dans la revue Nature les résultats d'un robot de tennis de table autonome baptisé Ace, capable de remporter trois matchs sur cinq contre des joueurs de niveau élite, soit des athlètes comptant plus de dix ans de pratique et vingt heures d'entraînement hebdomadaire en moyenne. Le robot a perdu ses deux confrontations face à des professionnels de la ligue japonaise, mais a remporté un set contre l'un d'eux, dont Yamato Kawamata lors d'un match en décembre 2025. Ace joue sur une table réglementaire, avec un équipement standard, contre des adversaires libres d'utiliser l'intégralité de leur répertoire technique. La balle peut dépasser 20 mètres par seconde et les joueurs professionnels peuvent lui imprimer une rotation jusqu'à 9 000 tours par minute, laissant moins d'une demi-seconde au robot pour évaluer la trajectoire et formuler une réponse. Pour percevoir cette dynamique, le système combine trois capteurs de vision événementielle (qui détectent les changements de luminosité plutôt que de capturer des images fixes) et neuf caméras haute vitesse. Un algorithme d'apprentissage par renforcement profond, entraîné sur plusieurs millions de rallyes simulés en self-play, recalcule les commandes de mouvement du bras articulé toutes les quelques dizaines de millisecondes, en évitant les collisions avec la table et avec le bras lui-même. Ce résultat dépasse le cadre du ping-pong : il constitue la première démonstration publiquement documentée d'un système IA autonome compétitif dans un environnement physique non contraint, à vitesse humaine et contre des adversaires experts. Contrairement aux victoires d'AlphaGo ou de Stockfish, obtenues dans des univers entièrement numériques aux règles fixes, Ace opère dans un espace où la physique, le spin et l'imprévisibilité humaine créent des conditions radicalement ouvertes. Pour l'industrie robotique, cela valide une chaîne technique complète : estimation de spin en temps réel via marquages visuels, transfert sim-to-real sur des tâches dynamiques rapides, et contrôle d'un bras multi-articulé sous contrainte temporelle sévère. Ces mêmes briques techniques (capteurs événementiels, RL simulé, contrôle rapproché temps réel) sont directement transférables à la manipulation industrielle haute cadence, au tri ou à l'assemblage fin, là où les systèmes actuels restent limités par leur latence de perception. Sony AI s'inscrit dans une trajectoire de recherche où la table de ping-pong sert depuis longtemps de banc de test pour la robotique physique. Le robot Forpheus d'Omron, développé depuis 2017, avait pavé la voie mais dans des conditions contraintes : lanceur de balles contrôlé, déplacements limités, effets de rotation peu ou pas pris en compte. Ace franchit un seuil qualitatif en jouant dans les mêmes conditions qu'un humain. Sony n'a pas encore annoncé de calendrier de commercialisation ni de partenariat industriel, et la publication Nature porte le statut d'avancée de recherche plutôt que de produit commercialisé. Du côté des concurrents, les efforts en robotique physique intelligente se concentrent ailleurs : Boston Dynamics sur la locomotion, Figure et 1X sur les humanoïdes polyvalents, Sanctuary AI sur la manipulation généraliste. Le vrai enjeu pour Sony sera de montrer si les innovations d'Ace peuvent migrer vers des cas d'usage industriels concrets, ou si elles restent cantonnées à un démonstrateur de laboratoire remarquable.

RecherchePaper
1 source