
Aller au contenu principal
Vidéo : une entreprise chinoise publie 11 430 trajectoires robotiques pour la recherche
RechercheInteresting Engineering 

Vidéo : une entreprise chinoise publie 11 430 trajectoires robotiques pour la recherche
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Vidéo : une entreprise chinoise publie 11 430 trajectoires robotiques pour la recherche
▶ Voir sur YouTube

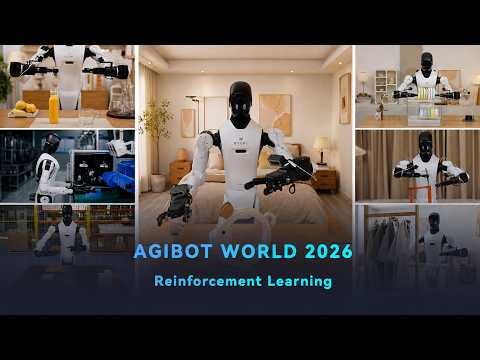
AGIBOT, entreprise chinoise spécialisée en robotique et intelligence artificielle incarnée, a mis en open source le 3 septembre 2026 son jeu de données WORLD 2026, plus précisément son volet Theme 3 consacré à l'apprentissage par renforcement. L'ensemble rassemble 11 430 trajectoires collectées en conditions réelles sur 14 tâches industrielles et domestiques, réparties en trois catégories: des démonstrations expertes réalisées par des opérateurs humains, des exécutions autonomes de politiques apprises (1 024 réussites et 1 369 échecs recensés), et des séquences d'intervention humaine documentant le comportement du robot avant, pendant et après la reprise en main par un opérateur. Chaque trajectoire est annotée sur la progression de la tâche, son statut de complétion, les erreurs rencontrées, les perturbations environnementales et les interventions humaines. Cette publication intervient peu après qu'AGIBOT a dominé la deuxième édition des World Humanoid Robot Games avec 46 médailles dont 18 en or, sa première participation à une compétition internationale.

L'intérêt de ce jeu de données tient à son objet: au lieu de ne compiler que des démonstrations réussies, comme le font la plupart des corpus utilisés pour l'apprentissage par imitation, AGIBOT capture aussi l'échec, l'hésitation et la correction. Pour les chercheurs en apprentissage par renforcement et IA incarnée, cela fournit un signal rarement disponible à cette échelle: comprendre où et pourquoi une politique autonome échoue, et comment une intervention humaine permet de récupérer la tâche. C'est un point sensible pour l'industrie, où l'écart entre les démonstrations soignées présentées en vidéo et la fiabilité réelle en déploiement reste un sujet de scepticisme récurrent chez les intégrateurs et les décideurs B2B. En rendant visibles ses propres échecs de politique, AGIBOT prend le contre-pied du marketing habituel du secteur et mise sur une stratégie de données ouvertes pour accélérer la recherche collective, plutôt que de garder ces données de déploiement en interne comme le font la plupart des laboratoires fermés développant des modèles vision-langage-action.

Theme 3 s'inscrit dans l'initiative plus large AGIBOT WORLD 2026, présentée comme une ressource ouverte destinée à la communauté de recherche en IA incarnée, qu'AGIBOT prévoit d'enrichir avec d'autres jeux de données et benchmarks. Ce mouvement s'ajoute à une multiplication d'efforts comparables dans le secteur des modèles vision-langage-action et de la robotique humanoïde, où plusieurs laboratoires publient des corpus ou des modèles pour faire progresser l'apprentissage à partir de données réelles plutôt que de simulation seule. Aucun calendrier de nouveaux jeux de données n'a été précisé par AGIBOT, qui dit vouloir permettre aux industries d'exploiter cette base pour améliorer la productivité et la fiabilité des déploiements robotiques quotidiens.

Impact France/UE

Les laboratoires européens de robotique et d'IA incarnée (type CEA-List, INRIA) pourraient exploiter ce jeu de données ouvert, mais aucun acteur ni déploiement français/européen n'est implique dans l'article.

Dans nos dossiers

À lire aussi

TrAct : relier le contrôle robotique et la prédiction visuelle par les trajectoires visuelles
1arXiv cs.RO 

TrAct : relier le contrôle robotique et la prédiction visuelle par les trajectoires visuelles

Des chercheurs présentent TrAct, un framework de décision robotique fonde sur un modèle du monde et structure autour de trois composants, dans un article publie sur arXiv (2608.24101). VLAT (Vision-Language-Action-and-Track) prédit conjointement des actions candidates et les trajectoires visuelles associées a partir d'une observation et d'une instruction en langage naturel. TWM (track-conditioned world model) projette ensuite les conséquences visuelles futures de ces trajectoires. VLAC (vision-language reward model) note les résultats prédits pour sélectionner la meilleure paire action-trajectoire, qui est alors exécutée par le robot. Sur un nouveau benchmark de simulation baptise LIBERO-INTEGRAL et sur un bras Franka en conditions réelles, TrAct fait passer le taux de réussite de 27% a 55% en simulation et de 49% a 76% en réel, compare a la référence Pi-0.5. Le module TWM améliore par ailleurs la qualité de prédiction vidéo par rapport a un modèle du monde conditionne uniquement par l'action (AWM). L'enjeu tient au problème cible: les actions robotiques sont spécifiques a chaque plateforme mécanique et ne correspondent que faiblement aux changements visuels dans l'image, ce qui limite leur usage comme signal de conditionnement pour les modèles du monde. Les tracks visuels, indépendants de l'embodiment, offrent un guide dense et spatialement précis pour anticiper l'action correcte, en s'insérant comme représentation intermédiaire entre perception, prédiction et contrôle. TrAct s'attaque ainsi a l'écart persistant entre performances en simulation et généralisation en conditions réelles, un point faible récurrent des architectures VLA. Les gains face a Pi-0.5, référence crédible du secteur, sont notables, mais le benchmark LIBERO-INTEGRAL est propose par les auteurs eux-mêmes et l'article n'a pas encore été relu par les pairs, ce qui appelle une reproduction indépendante avant toute conclusion définitive pour l'industrie. Ces travaux s'inscrivent dans la vague de recherche sur les modèles Vision-Language-Action, aux cotes de Pi-0 et Pi-0.5 chez Physical Intelligence, GR00T N2 chez Nvidia ou Helix chez Figure AI. L'usage d'un bras Franka Emika comme plateforme d'évaluation reste un standard académique, loin des déploiements en usine revendiques par des acteurs comme Figure (Figure 03) ou Tesla (Optimus). Aucun acteur français ou européen, tel Wandercraft, Pollen Robotics ou Enchanted Tools, n'apparait dans cette étude, qui demeure a ce stade une contribution de recherche en preprint, sans partenariat industriel ni calendrier de déploiement annonce.

RechercheOpinion
1 source
Modèles du monde vidéo pour la robotique : applications, défis de recherche et perspectives d'avenir
2arXiv cs.RO 

Modèles du monde vidéo pour la robotique : applications, défis de recherche et perspectives d'avenir

Une équipe de chercheurs affiliée au laboratoire IRoM de l'université de Princeton publie une revue de littérature sur les "video world models" (modèles de monde vidéo) appliqués à la robotique, mise à jour en version 2 sur arXiv sous l'identifiant 2601.07823. Le papier recense l'état de l'art sur l'usage de générateurs vidéo comme modèles de monde incarnés couvrant cinq usages principaux : la génération de données d'entraînement, l'apprentissage de politiques, la modélisation de la dynamique et des récompenses pour l'apprentissage par renforcement, l'évaluation de politiques et la planification visuelle. Les auteurs soulignent la capacité de ces modèles à produire des simulations de corps déformables photoréalistes et physiquement cohérentes sans les simplifications lourdes des simulateurs physiques classiques, tout en documentant des limites persistantes : mauvais suivi des instructions, hallucinations se traduisant par des violations des lois de la physique, génération de contenu non sûr, et coût de calcul et de données prohibitif. Une bibliographie organisée et ouverte à la communauté est mise à disposition sur GitHub, à l'adresse irom-princeton/awesome-robotics-vidéo-world-model-papers. Pour l'industrie robotique, ce travail synthétise un argument structurant : les modèles vidéo pourraient remplacer, ou compléter, les simulateurs physiques traditionnels comme brique de génération de données synthétiques et d'évaluation de politiques, réduisant la dépendance coûteuse à la collecte de données réelles ou au réglage fin d'environnements simulés, un enjeu direct pour l'entraînement des modèles vision-langage-action (VLA) dont le goulot d'étranglement reste la quantité et la diversité des démonstrations disponibles. Mais la revue tempère l'enthousiasme ambiant autour des "foundation world models" : les hallucinations physiques documentées par les auteurs montrent que ces générateurs, aussi impressionnants visuellement, ne garantissent pas encore la cohérence physique nécessaire à un usage fiable dans des boucles d'entraînement ou d'évaluation critiques pour la sécurité. Pour les intégrateurs et décideurs B2B, le message est de traiter ces outils comme prometteurs mais encore expérimentaux plutôt que comme des remplaçants prêts à l'emploi des pipelines de simulation existants. Cette synthèse s'inscrit dans la vague de recherche déclenchée par les progrès des modèles de diffusion et de génération vidéo appliqués hors du divertissement, où plusieurs laboratoires explorent, dans le sillage de l'essor des modèles vision-langage-action, leur usage comme substituts ou compléments aux moteurs physiques classiques pour la robotique. En consolidant la littérature existante sous forme de taxonomie des usages et de liste structurée de défis ouverts, les auteurs visent moins à annoncer un produit qu'à orienter les efforts de recherche à venir vers des solutions plus fiables pour les déploiements en environnements critiques pour la sécurité. Le projet reste académique, sans produit commercial ni partenariat industriel annoncé, mais la base bibliographique collaborative hébergée sur GitHub, ouverte aux contributions, indique que le sujet est appelé à structurer les prochains travaux sur les modèles de fondation en robotique.

UECette synthèse académique en libre accès sur GitHub peut orienter les laboratoires de recherche européens en robotique, sans impliquer d'acteur ou de régulation française ou européenne.

RecherchePaper
1 source
GraphPoint : graphes d'entités sémantiques et trajectoires de points pour la manipulation robotique compositionnelle
3arXiv cs.RO 

GraphPoint : graphes d'entités sémantiques et trajectoires de points pour la manipulation robotique compositionnelle

Un article déposé sur arXiv (référence 2609.18358) début septembre 2026 présente GraphPoint, une méthode de manipulation robotique associée à un nouveau benchmark baptisé CoMani. Le travail part d'un constat répandu en robotique : les politiques de manipulation entraînées par apprentissage peinent à généraliser au-delà de leurs démonstrations, même quand une nouvelle instruction combine des objets et des comportements déjà vus séparément. Les auteurs expliquent que lorsque langage et scène visuelle sont trop fortement corrélés pendant l'entraînement, la politique finit par mémoriser un mapping visuo-moteur fixe au lieu de réellement suivre l'instruction donnée. CoMani propose des scènes initiales appariées et des variations contrôlées portant sur un seul facteur sémantique à la fois, afin de forcer les modèles évalués à s'appuyer sur le langage plutôt que sur des raccourcis visuels. Deux niveaux de généralisation compositionnelle sont testés : à l'intérieur d'une sous-tâche, en recombinant entités, types d'action et modificateurs déjà connus, et entre sous-tâches, en réutilisant des comportements appris dans des tâches longues et inédites. GraphPoint, la méthode proposée, relie des graphes d'entités sémantiques à un contrôle géométrique en prédisant la trajectoire future du point de préhension du gripper, convertie ensuite en commandes moteur via la géométrie du robot ; le gripper et les objets sont organisés par rôles sémantiques et leurs interactions conditionnées par le type et le modificateur d'action demandés, tandis qu'une estimation de progression guide les transitions entre étapes. L'enjeu dépasse la seule démonstration technique : il touche directement le problème de l'écart entre performance affichée sur des tâches déjà vues et robustesse réelle en usage, un point sensible pour tout intégrateur évaluant une politique vision-langage-action avant déploiement industriel. En isolant précisément si un modèle suit l'instruction ou reconnaît simplement une scène mémorisée, CoMani offre aux équipes de recherche un outil de diagnostic plus rigoureux que les démonstrations vidéo sélectionnées qui dominent souvent la communication du secteur autour des capacités de généralisation. Le papier s'inscrit dans la vague récente de benchmarks cherchant à mesurer la généralisation compositionnelle des politiques de manipulation plutôt que leur seule réussite sur des tâches figées. Les auteurs indiquent que le code sera publié en accès libre sous le nom GraphPoint, sans préciser de calendrier ni d'institution porteuse. Aucun partenariat industriel, déploiement réel ou chiffre de performance chiffré au-delà des résultats d'ablation sur CoMani n'est mentionné à ce stade, ce qui situe cette publication au stade de la recherche amont plutôt que du produit commercialisable.

RecherchePaper
1 source
L'Open Ant, une plateforme robotique pour la recherche en apprentissage par renforcement
4arXiv cs.RO 

L'Open Ant, une plateforme robotique pour la recherche en apprentissage par renforcement

Une équipe de recherche présente l'Open Ant, une plateforme robotique physique conçue pour la recherche en apprentissage par renforcement (RL), dans un article publié sur arXiv (2607.18488v1). Il s'agit d'une déclinaison matérielle de l'environnement Gymnasium Ant, un benchmark de simulation largement utilisé dans la communauté RL, accompagnée de sa propre simulation. Les chercheurs démontrent que des politiques de marche compétentes peuvent être apprises directement à partir de l'expérience du robot physique, sans passer par la simulation, en environ une heure seulement. Ce résultat a été obtenu avec deux algorithmes très différents dans leur approche, SARSA(λ) et Soft Actor-Critic (SAC), ce qui suggère une certaine robustesse de la plateforme face à des méthodes d'apprentissage variées. Les auteurs montrent également que des politiques entraînées en simulation se transfèrent avec succès vers le robot réel. L'ensemble, conception matérielle et logiciel, est publié en open source sur GitHub. Cette publication s'attaque à un problème structurel du champ du RL: la grande majorité des travaux restent cantonnés à la simulation, ce qui rend incertaine leur transposition à des systèmes physiques réels, tant pour les algorithmes que pour les chercheurs qui manquent souvent d'accès à du matériel adapté. En apportant la preuve qu'un apprentissage from scratch sur robot réel est possible en une heure, et que le transfert sim-to-real fonctionne sur cette plateforme, les auteurs fournissent un argument concret contre l'idée que le RL physique serait nécessairement lent, coûteux ou peu fiable. Pour les laboratoires académiques et les équipes industrielles travaillant sur des systèmes de locomotion ou de contrôle appris, cela abaisse la barrière à l'expérimentation matérielle. Le choix de dériver la plateforme de l'environnement Gymnasium Ant, très utilisé comme référence en simulation, vise explicitement à faciliter l'adoption par des chercheurs déjà familiers de cet environnement virtuel. Les auteurs ont aussi évalué l'accessibilité du système pour des utilisateurs novices issus de formations diverses, ainsi que la facilité de réparation et de mise à jour du matériel en cas de panne, deux critères rarement documentés dans les publications robotiques mais déterminants pour une adoption réelle en laboratoire.

RecherchePaper
1 source