
Aller au contenu principal
Vidéo : un robot humanoïde apprend à combattre et à s'entraîner de façon autonome, sans contrôle humain
IA physiqueInteresting Engineering 

Vidéo : un robot humanoïde apprend à combattre et à s'entraîner de façon autonome, sans contrôle humain

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Vidéo : un robot humanoïde apprend à combattre et à s'entraîner de façon autonome, sans contrôle humain
▶ Voir sur YouTube

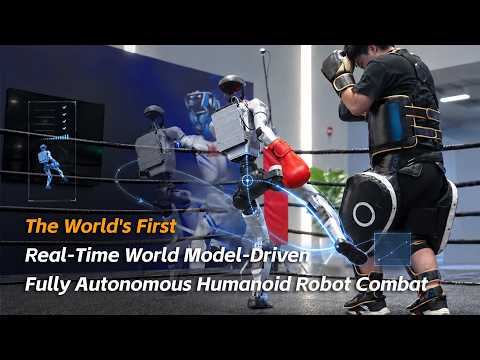
Unitree Robotics a publié une vidéo montrant son robot humanoïde G1 combattre en sparring, sans télécommande, face à un partenaire humain. Le système repose sur un nouveau modèle d'IA baptisé UnifoLM-X2-1.0, qui remplace le pilotage classique via casque VR ou manette par une architecture de perception-action prédictive : elle traite en continu l'environnement, anticipe l'évolution probable de la scène et du geste de l'adversaire, puis planifie les mouvements du robot avant leur exécution. Dans la vidéo, le G1 ajuste sa garde et son jeu de jambes, esquive des coups entrants et enchaîne poings et pieds en temps réel. Des visualisations superposées montrent les prédictions de trajectoires futures intégrées au planning moteur. Unitree présente UnifoLM-X2-1.0 comme un modèle "monde-action" conçu pour réduire le délai entre perception, décision et action physique lors d'interactions très dynamiques. Un détail technique tempère toutefois l'annonce : les journaux de la console affichent des commandes comme OBS/replan et env.step, ce qui suggère que les données des capteurs sont envoyées à un ordinateur externe exécutant le modèle, qui renvoie ensuite les instructions de mouvement au robot. Le calcul embarqué complet n'est donc pas encore acquis.

Cette démonstration marque une étape dans le passage des humanoïdes du télépilotage vers une autonomie de décision réelle, un enjeu suivi de près par les intégrateurs et décideurs industriels qui veulent des robots capables de réagir à des environnements physiques changeants sans opérateur. Le combat sert ici de banc d'essai extrême pour l'IA physique : si un robot peut prédire les mouvements d'un adversaire, garder son équilibre et répondre à des contacts imprévus en une fraction de seconde, la même architecture pourrait, selon Unitree, sécuriser des tâches en environnement industriel complexe où collisions et imprévus sont fréquents. Mais la dépendance apparente à un calcul déporté relativise la promesse d'autonomie totale et rappelle l'écart persistant entre démonstration filmée et déploiement en conditions réelles, un travers récurrent du secteur humanoïde.

UnifoLM-X2-1.0 s'inscrit dans la famille de modèles fondation qu'Unitree développe depuis ses premiers systèmes dédiés à la manipulation en usine, désormais élargis vers des architectures multimodales combinant perception, prédiction du monde et action. La démonstration positionne Unitree face aux autres approches VLA du secteur, comme Pi-0 de Physical Intelligence, GR00T N2 de NVIDIA ou Helix de Figure AI, toutes engagées dans la course à des modèles généralistes capables de contrôler un corps humanoïde sans scripts figés. Aucune date de déploiement commercial ni de pilote industriel n'a été communiquée à ce stade ; la vidéo reste une démonstration de capacité technologique, destinée à illustrer la trajectoire de recherche d'Unitree plutôt qu'un produit prêt à l'emploi.

À lire aussi

Vidéo : un nouveau robot humanoïde vide le linge et plie des serviettes sans aide humaine
1Interesting Engineering 

Vidéo : un nouveau robot humanoïde vide le linge et plie des serviettes sans aide humaine

Dyna Robotics, start-up californienne, a présenté le 29 septembre 2026 Dyna-2.1, qu'elle qualifie d'« agent physique » capable d'enchaîner de très longs flux de travail avec l'ensemble du corps, sans intervention humaine. La démonstration, en vidéo non coupée selon l'entreprise, se déroule dans une laverie commerciale. Le robot charge et démarre lui-même lave-linge et sèche-linge, se penche pour extraire les serviettes du fond d'un sèche-linge et les transfère dans un panier. Il les secoue pour les mettre à plat, les plie, les trie par taille en piles, puis les range sur des étagères en s'accroupissant pour les niveaux bas ou en tendant les bras vers les niveaux hauts. Il récupère une serviette tombée au sol et, après une prise ratée, abandonne la tentative pour en refaire une. Côté matériel, la machine est un « semi-humanoïde » : un torse et deux bras montés sur une base à quatre roues directrices, avec pinces parallèles ou mains dextres au choix. Un orchestrateur vision-langage planifie le flux, un contrôleur du corps entier coordonne déplacement et mouvements des bras, et le tout repose sur Dyna-2, un « world action model » propriétaire entraîné, selon l'entreprise, sur un million d'heures de données humaines et robotiques. Dyna affirme déployer le robot dans des hôtels, des laveries et des restaurants, sans chiffrer le nombre d'unités, les sites ni le prix. L'intérêt tient moins à la dextérité, déjà montrée par d'autres, qu'au choix de mesure. Dyna met en avant le MTBI (Mean Time Between Interventions), c'est-à-dire la durée de fonctionnement avant qu'un humain doive intervenir, plutôt que le taux de réussite d'une tâche isolée. C'est l'indicateur qui compte pour un exploitant : un poste complet sans « baby-sitter », comme le dit le CEO Lindon Gao. Il déplace la discussion de la démo vers la fiabilité opérationnelle, là où se joue l'écart entre vidéo et réalité. Le choix d'une base à roues, qui évite le problème d'équilibre de la marche bipède, illustre aussi un pari pragmatique : pour la logistique, l'hôtellerie ou la blanchisserie, la forme humanoïde complète n'est pas nécessairement utile. Il faut toutefois rester prudent : Dyna ne publie aucune valeur de MTBI, ni durée de la séquence, ni taux d'interventions. Une vidéo unique en environnement contrôlé ne prouve pas la fiabilité sur un poste de huit heures, et les déploiements évoqués restent non documentés. Dyna Robotics s'inscrit dans la vague des modèles fondation pour la manipulation, aux côtés de Physical Intelligence (Pi-0), de Figure (Helix) ou de NVIDIA (GR00T), avec un positionnement plus commercial que la plupart : des tâches de service à valeur immédiate plutôt qu'un humanoïde généraliste. Sa stratégie rejoint celle des bases mobiles à deux bras, concurrentes directes des humanoïdes marchants pour les usages en intérieur. L'entreprise décrit une boucle d'amélioration continue : les traces de décision de l'orchestrateur et les charges articulaires du contrôleur sont réinjectées pour allonger le temps entre interventions. La suite se jugera sur des chiffres de MTBI vérifiables, des clients nommés et des volumes de déploiement, aucun de ces éléments n'étant encore public.

UEPas d\'impact direct sur la France/UE

IA physiqueOpinion
1 source
Video2Sim2Real : apprentissage autonome et complet de compétences dextériques à partir d'une seule vidéo humaine
2arXiv cs.RO 

Video2Sim2Real : apprentissage autonome et complet de compétences dextériques à partir d'une seule vidéo humaine

Des chercheurs ont publié début juin 2026 Video2Sim2Real (arXiv:2606.08828), un pipeline complet permettant à un robot d'acquérir des compétences de manipulation dextre à partir d'une seule vidéo de démonstration humaine. Le système fonctionne en trois étapes : des modèles de fondation reconstruisent un jumeau numérique prêt pour la simulation, extraient les trajectoires main-objet, puis identifient des keyframes orientés objet pour optimiser les configurations articulaires du robot. Ces configurations servent d'ancres pour recalibrer le mouvement brut, comblant l'écart entre la cinématique humaine et les contraintes d'un end-effector mécanique. Pour le transfert sim-to-real, le framework dissocie deux problèmes distincts : la robustesse aux nuages de points bruités du monde réel, traitée par apprentissage par imitation (IL), et les variations de dynamique doigt-objet, gérées par du RL résiduel local au niveau des phalanges. Un module de planification collision-aware permet enfin la généralisation spatiale à des configurations d'objets inédites. L'intérêt principal pour les intégrateurs et équipes R&D est l'absence de démonstrations téléopérées coûteuses : une seule vidéo d'un humain effectuant une tâche suffit à bootstrapper la politique. C'est une réponse directe au "demonstration bottleneck" qui freine le déploiement des robots manipulateurs en environnements non structurés. La décomposition explicite du gap sim-to-real en deux sous-problèmes indépendants est méthodologiquement solide et contraste avec les approches end-to-end qui peinent à diagnostiquer leurs propres échecs. Sur plusieurs tâches de manipulation quotidienne, le système améliore le taux de succès en simulation, la sécurité et la cohérence des trajectoires face à de nombreuses baselines existantes. Il faut noter cependant que le papier ne publie pas de métriques de succès absolues consolidées en conditions réelles ; les évaluations demeurent comparatives, ce qui limite l'interprétation des gains annoncés. Cette direction s'inscrit dans un mouvement plus large exploitant les vidéos comme supervision faible pour la robotique, à l'instar de π0 (Physical Intelligence), GR00T N2 (NVIDIA) ou UniSim. Video2Sim2Real se distingue en visant la pipeline complète, de la vidéo brute au déploiement réel, sans intervention intermédiaire. Les approches concurrentes comme DexMV ou AnyTeleop requièrent généralement des données supplémentaires (MoCap, téléopération) ou restent limitées à des scènes très contraintes. Aucun déploiement industriel n'est annoncé à ce stade ; les prochaines étapes naturelles seraient une validation sur des end-effectors commerciaux (Allegro Hand, Shadow Dexterous Hand) et une mise à l'épreuve sur des objets articulés ou déformables, là où la dynamique de contact reste un problème ouvert.

UELes équipes R&D françaises et européennes spécialisées en manipulation dextre peuvent intégrer cette approche pour s'affranchir de la téléopération coûteuse, sans partenariat ou initiative EU spécifique annoncé.

IA physiqueOpinion
1 source
Vidéo : le cerveau robotique de Genesis permet une manipulation au niveau humain et un entraînement à grande échelle
3Interesting Engineering 

Vidéo : le cerveau robotique de Genesis permet une manipulation au niveau humain et un entraînement à grande échelle

Genesis AI a présenté GENE-26.5, un modèle de fondation robotique conçu pour doter les robots de capacités de manipulation au niveau humain. La vidéo de démonstration publiée par l'entreprise montre des robots accomplissant une séquence culinaire de 20 étapes (couper des tomates, casser un oeuf d'une seule main, coordonner les deux bras pendant la cuisson), ainsi que la préparation d'un smoothie avec service en l'air, des tâches de laboratoire (pipettage, transfert de liquides), du câblage pour assemblage électronique, la résolution d'un Rubik's Cube en manipulation aérienne continue, et l'interprétation d'une pièce de piano rapide. Pour alimenter l'entraînement du modèle, l'entreprise a développé un gant haptique équipé d'une peau électronique à capteurs tactiles, établissant une correspondance 1:1:1 entre la main humaine, le gant et la main robotique. Genesis revendique un coût matériel cent fois inférieur aux solutions de télé-opération conventionnelles, et une efficacité de collecte de données cinq fois supérieure. Le moteur de données associé intègre également des vidéos égocentriques issues de caméras portables et des vidéos publiques centrées sur l'activité humaine. Ces résultats, s'ils se confirment en environnement réel non contrôlé, représentent une avancée potentiellement significative sur l'un des verrous les plus tenaces de la robotique : l'écart d'incarnation (embodiment gap) entre les mains humaines et robotiques, qui limite depuis des années la transférabilité des données d'entraînement. La cartographie 1:1 glove-to-robot est une approche déjà explorée par des acteurs comme Physical Intelligence (pi-0) et plusieurs laboratoires académiques, mais Genesis revendique une démonstration à une échelle et une polyvalence inédites. Pour les intégrateurs industriels et les décideurs cherchant à automatiser des tâches non structurées (assemblage fin, préparation culinaire en volume, logistique d'entrepôt), la promesse d'un système généraliste capable d'apprendre directement des gestes humains quotidiens, sans retraining extensif, représenterait un changement de paradigme. Il faut toutefois noter que les démonstrations sont des vidéos éditées, sans données indépendantes sur le taux d'échec, les conditions d'éclairage, ou la reproductibilité en cycle de production continu. Genesis AI s'inscrit dans un segment en forte concurrence avec Physical Intelligence (pi-0, Berkeley), Figure AI (Figure 03, déployé avec BMW), Tesla (Optimus Gen 3), NVIDIA (GR00T N2) et Apptronik (Apollo). L'approche par gant haptique à bas coût rappelle les travaux d'Enchanted Tools, acteur français du service robotique, qui mise également sur la capture de mouvement humain pour réduire le coût d'entraînement. Genesis n'a pas encore annoncé de déploiements industriels confirmés ni de partenariats nominatifs : GENE-26.5 reste à ce stade une annonce de produit accompagnée d'une démonstration vidéo, pas un système disponible commercialement. L'entreprise indique prévoir le déploiement de ses gants en milieu de travail réel via des partenariats industriels, avec pour objectif de constituer une bibliothèque de compétences humaines à grande échelle pour l'entraînement robotique.

IA physiqueActu
1 source
Nouveau robot humanoïde capable de courir, sauter et danser sur simple commande
4Interesting Engineering 

Nouveau robot humanoïde capable de courir, sauter et danser sur simple commande

Des chercheurs de NVIDIA ont présenté SONIC, un framework de contrôle pour robots humanoïdes capable de générer des mouvements corps entier à partir de plusieurs types d'entrées : téléopération, vidéo, texte ou musique. Plutôt que d'entraîner un contrôleur distinct par compétence, comme c'est la norme dans le secteur, SONIC repose sur une politique unique entraînée sur plus de 100 millions de frames de mouvement, issues d'environ 700 heures de capture de mouvement humain. Le modèle le plus grand compte 42 millions de paramètres, entraîné sur jusqu'à 128 GPU pour un total d'environ 21 000 heures GPU. Le système s'appuie sur un espace de tokens universel : des encodeurs spécialisés traitent le mouvement robotique, le mouvement humain et les commandes hybrides avant de les convertir en tokens quantifiés alimentant un décodeur de contrôle commun. Un planificateur cinématique en temps réel génère des segments de mouvement entre points clés et permet de replanifier en continu, sans réentraînement, pour changer de direction, de vitesse ou de style de déplacement. Déployé sur un robot humanoïde Unitree G1, SONIC a atteint un taux de réussite de 99,2% sur 123 séquences de mouvement réelles, contre 100% en simulation, soit un écart jugé faible entre les deux environnements. Le système a aussi été connecté à un modèle vision-langage-action. Cette approche répond à une limite structurelle du contrôle humanoïde actuel : la plupart des politiques existantes sont des réseaux de neurones relativement compacts, conçus pour une tâche précise, ce qui oblige à ré-ingénierer des objectifs et un entraînement à chaque nouveau comportement. En traitant le suivi de mouvement comme un problème d'apprentissage à grande échelle plutôt que comme une somme de compétences isolées, NVIDIA cherche à démontrer qu'une seule politique peut généraliser à des mouvements jamais vus à l'entraînement, une promesse centrale pour l'autonomie humanoïde généraliste. Pour les intégrateurs et décideurs industriels, l'enjeu dépasse la prouesse technique : un écart sim-to-real limité, associé à une architecture capable d'ingérer indifféremment vidéo, texte ou musique, laisse entrevoir des pipelines de déploiement plus rapides, sans réentraînement coûteux par cas d'usage. Le taux de succès de 99,2% porte toutefois sur un jeu de 123 séquences choisies par les chercheurs eux-mêmes, sans comparaison indépendante ni détail sur la nature exacte des tâches testées, une réserve à garder en tête avant d'en tirer des conclusions générales sur la robustesse en conditions réelles. SONIC s'inscrit dans la stratégie robotique plus large de NVIDIA, qui développe par ailleurs la plateforme de fondation GR00T, dont la version N2, ainsi que les outils de simulation Isaac utilisés pour l'apprentissage sim-to-real. Le champ du contrôle humanoïde généraliste est aussi disputé par Figure AI avec son système Helix, ou par des modèles vision-langage-action comme Pi-0 de Physical Intelligence, qui poursuivent des objectifs similaires de politique unique couvrant un large répertoire de comportements. Contrairement à un produit commercial livré, SONIC reste à ce stade une démonstration de recherche, publiée avec des résultats en simulation et sur un seul robot physique, le Unitree G1. L'équipe NVIDIA indique vouloir en faire une fondation sur laquelle brancher des couches de perception et de raisonnement de plus haut niveau, en vue d'une intégration future avec des modèles vision-langage-action, sans qu'aucun calendrier de déploiement commercial ni partenariat industriel n'ait été communiqué à ce stade.

IA physiqueOpinion
1 source